> ## Documentation Index
> Fetch the complete documentation index at: https://docs.befailproof.ai/llms.txt
> Use this file to discover all available pages before exploring further.
# كتابة تقييم
> صف ما تريد قياسه واترك للمساعد صياغة تقييم Python مستضاف، أو اكتب الكود بنفسك. تعمل حكام LLM في عاملك الخاص.
التقييمات المستضافة عبارة عن أكواد Python صغيرة وحتمية، مكتوبة في لوحة التحكم وتعمل على أسطول تقييم Failproof AI. المنطق الأثقل — حكم LLM، أو حزمة، أو سر، أو استدعاء شبكة — يعمل في [عاملك الخاص](#اكتبه-في-عاملك-الخاص) بدلاً من ذلك.
## صغه من وصف
1. اذهب إلى **Analyze → eval authoring** واختر **new eval**.
2. صف ما تريد قياسه بالإنجليزية العادية، أو اختر من **start from an example…**، ثم اختر **draft**.
3. راجع الحقول والكود الذي يملأها، ثم [اختبره](/ar/evaluations/test) و[انشره](/ar/evaluations/deploy).
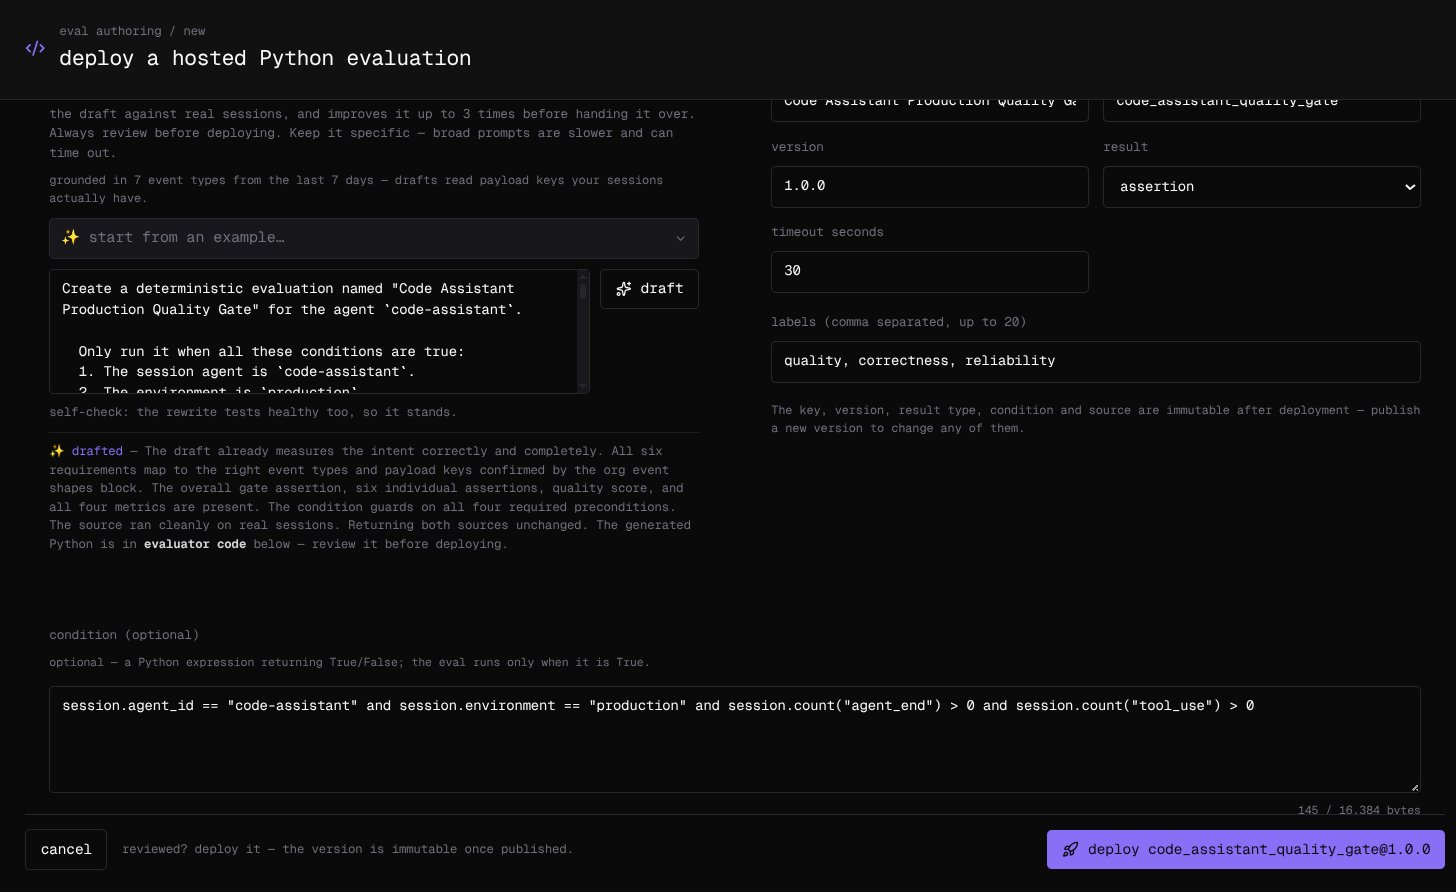 المسودة مبنية على الأحداث الخاصة بمؤسستك: تقرأ الصفحة مفاتيح الحمولة التي حملتها جلساتك على مدار السبعة أيام الماضية، لذا يقرأ الكود المفاتيح الموجودة بدلاً من التخمين. قبل تسليم المسودة، يختبرها المساعد مقابل ما يصل إلى خمس من جلساتك الأخيرة، ويصلح كل ما يمكنه إثبات أنه معطوب — لمدة تصل إلى ثلاث جولات — وفحص مرة واحدة أن الكود يقيس ما طلبته. احتفظ بالوصف محددًا: الطلبات العامة أبطأ ويمكن أن تنقطع. راجع الكود على أي حال؛ النشر لا يتم حظره أبدًا.
## تعيين الحقول
| حقل | ما هو |
| --------------- | ---------------------------------------------------------------------------- |
| name | ما يراه الناس. قابل للتعديل لاحقًا |
| key | المعرف المستقر الذي تخطط تحته النتائج، مثل `code_assistant_quality_gate` |
| version | أي سلسلة إصدار بدون مسافات، مثل `1.0.0` |
| result | **score** (من 0 إلى 1)، **metric** (رقم بوحدة)، أو **assertion** (نجح أو لا) |
| timeout seconds | افتراضي 30. يوقف الحماية أي تشغيل فردي عند 60 |
| labels | حتى 20، مفصولة بفواصل. قابلة للتعديل لاحقًا |
| condition | اختياري. تعبير Python؛ يعمل التقييم فقط على الجلسات حيث يكون `True` |
استخدم الشرط لتحديد نطاق التقييم للعوامل والبيئات المخصصة له:
```python theme={null}
session.agent_id == "code-assistant" and session.environment == "production"
```
المفتاح والإصدار ونوع النتيجة والشرط والكود ثابتة بمجرد النشر: لتغيير أي منها، انشر إصدارًا جديدًا. الاسم والتسميات وما إذا كانت مفعلة تبقى قابلة للتعديل.
## اكتب الكود بنفسك
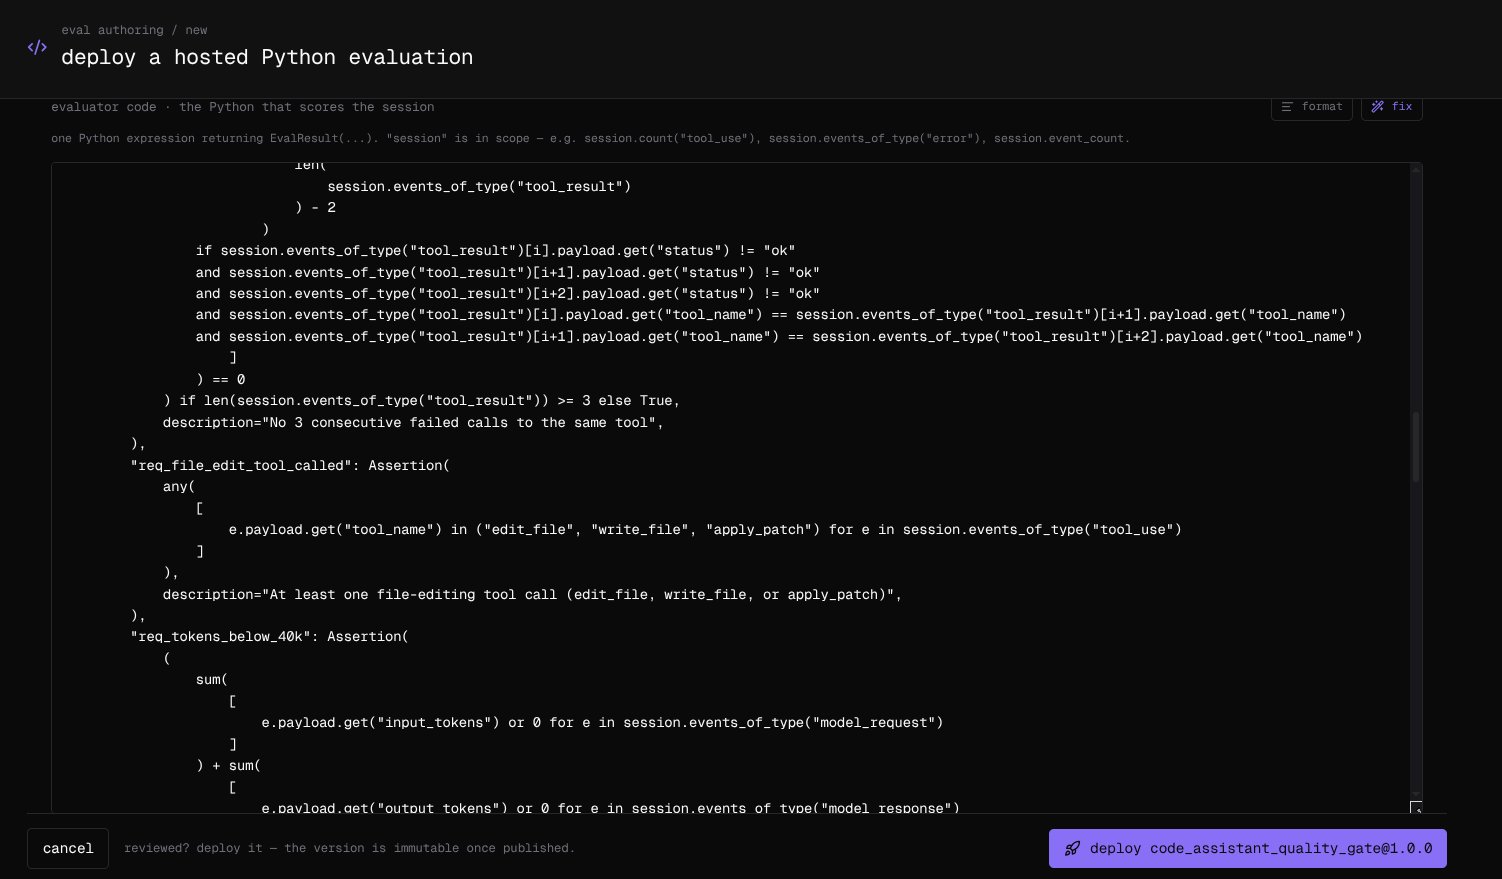
**كود المقيّم** هو تعبير Python واحد يُرجع `EvalResult(...)`، مع وجود `session` في النطاق. هذا الواحد يسجل حصة نتائج الأداة التي عادت بشكل صحيح:
```python theme={null}
EvalResult(
score=Score(
len([e for e in session.events_of_type("tool_result") if e.payload.get("status") == "ok"])
/ max(1, session.count("tool_result"))
),
metrics={"tool_calls": Metric(session.count("tool_use"), unit="calls")},
reasoning="Share of tool results that came back ok.",
)
```
تبدأ النتيجة بمفتاح التقييم الخاص به، في نوعه المعلن: `score=` لتقييم النقاط، أو إدخال `metrics` أو `assertions` باسم المفتاح لتقييم متري أو مؤكدة. تأتي المقاييس والمؤكدات الأخرى معها، حتى 25 نتيجة في التشغيل.
| في النطاق | يعطيك |
| ------------- | ----------------------------------------------------------------------------------------------------------------------------------------------------------- |
| `session` | `session_id`، `agent_id`، `environment`، `started_at`، `ended_at`، `event_count`، و`events`، بالإضافة إلى `count(event_type)` و`events_of_type(event_type)` |
| كل حدث | `id`، `ts`، `event_type`، و`payload` |
| أنواع النتائج | `EvalResult`، `Score`، `Metric`، `Assertion`، و`ConditionResult` للشرط |
| Builtins | `abs`، `all`، `any`، `bool`، `dict`، `float`، `int`، `len`، `list`، `max`، `min`، `range`، `round`، `set`، `sorted`، `str`، `sum`، `tuple` |
لا شيء آخر قابل للوصول: لا استيراد، ولا سمات تتجاوز بيانات الجلسة وطرق السلسلة والقاموس البسيطة مثل `get` و`lower` و`split`، والتي يجب استدعاؤها بدلاً من الإشارة إليها. مفاتيح الحمولة هي كل ما يرسله وكلاء عملك — `status` أعلاه مثال فقط — لذا اقرأها من جلسة حقيقية. **format** يرتب الكود و**fix** يطلب من المساعد إصلاحه. يمكن أن يكون الكود حتى 128 KiB، والشرط حتى 16 KiB.
 ## اكتبه في عاملك الخاص
عندما يحتاج التقييم إلى نموذج أو حزمة أو سر أو شبكة، اكتبه باستخدام [Evaluator SDK](/ar/reference/evaluator-sdk) وشغّله على البنية التحتية الخاصة بك. يستخدم نفس أنواع النتائج، وتظهر نتائجه بجانب النتائج المستضافة، موسومة **customer**:
```python theme={null}
@app.eval("answer_relevance", version="judge-v1", labels=["llm_judge"], timeout_seconds=30)
async def answer_relevance(session):
value, reasoning = await ask_judge(session) # your LLM call: a 0-1 score and why
return EvalResult(score=Score(value, passed=value >= 0.7), reasoning=reasoning)
```