> ## Documentation Index
> Fetch the complete documentation index at: https://docs.befailproof.ai/llms.txt
> Use this file to discover all available pages before exploring further.
# Eine Evaluierung schreiben
> Beschreibe, was gemessen werden soll, und lass den Assistenten eine gehostete Python-Evaluierung entwerfen, oder schreibe den Code selbst. LLM-Richter laufen in deinem eigenen Worker.
Gehostete Evaluierungen sind kleine, deterministische Python-Programme, die im Dashboard geschrieben und auf der Evaluator-Flotte von Failproof AI ausgeführt werden. Aufwendigere Logik — ein LLM-Richter, ein Paket, ein Secret, ein Netzwerkaufruf — läuft stattdessen [in deinem eigenen Worker](#im-eigenen-worker-schreiben).
## Aus einer Beschreibung entwerfen
1. Gehe zu **Analyze → eval authoring** und wähle **new eval**.
2. Beschreibe auf Englisch, was gemessen werden soll, oder wähle unter **start from an example…** ein Beispiel aus, und klicke auf **draft**.
3. Überprüfe die Felder und den generierten Code, [teste die Evaluierung](/de/evaluations/test) und [stelle sie bereit](/de/evaluations/deploy).
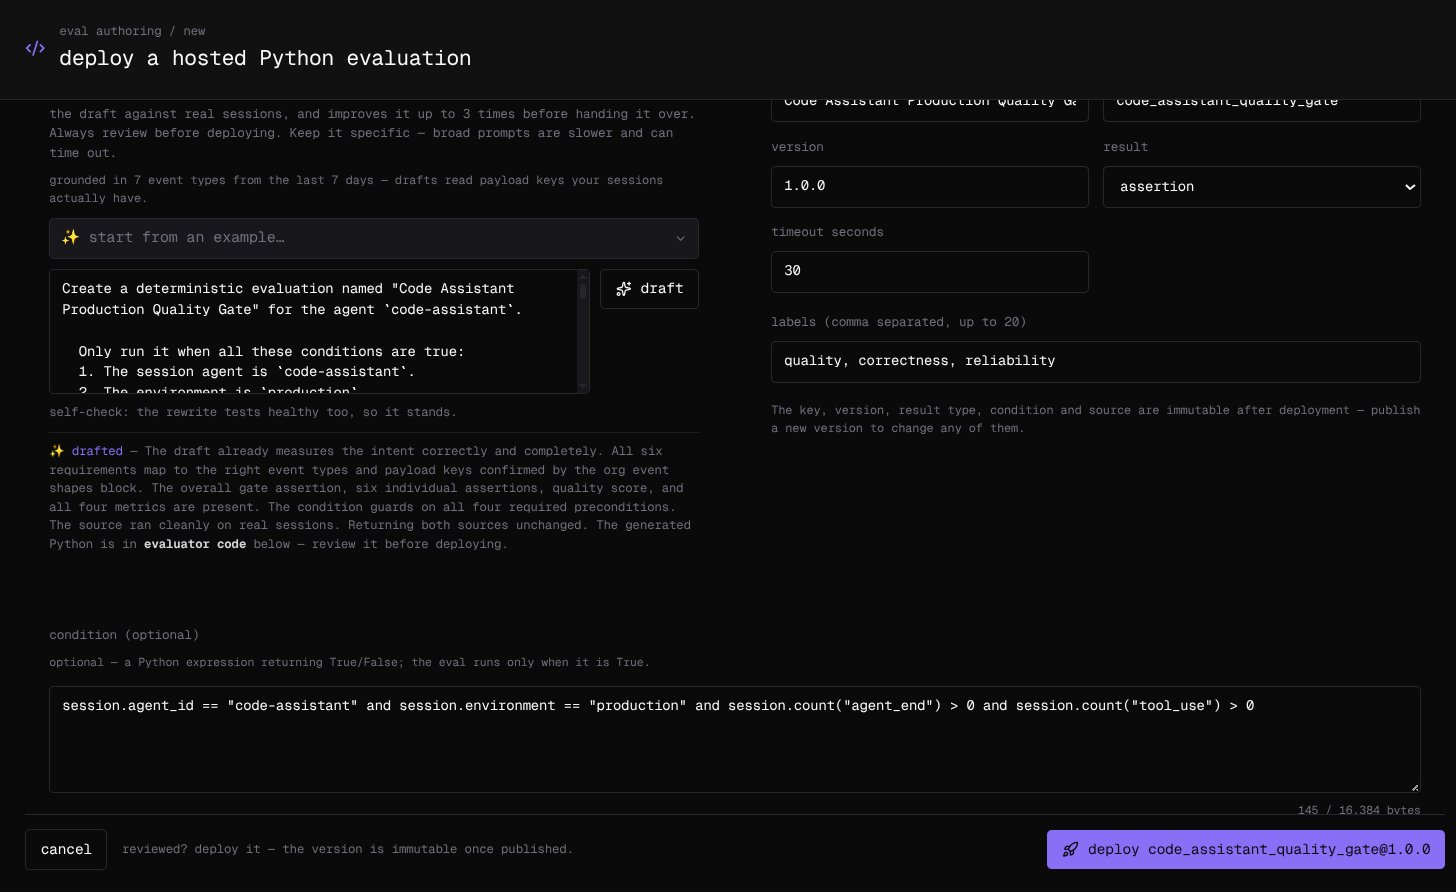 Der Entwurf basiert auf den eigenen Events deiner Organisation: Die Seite liest aus, welche Payload-Schlüssel deine Sessions in den letzten sieben Tagen verwendet haben, sodass der Code auf tatsächlich vorhandene Schlüssel zugreift und nicht rät. Bevor der Entwurf übergeben wird, testet der Assistent ihn gegen bis zu fünf deiner neuesten Sessions, behebt nachweisbare Fehler — in bis zu drei Runden — und prüft einmalig, ob der Code das misst, was du angefragt hast. Formuliere die Beschreibung möglichst präzise: Zu allgemeine Prompts sind langsamer und können zu Timeouts führen. Überprüfe den Code in jedem Fall; das Deployment wird dadurch nicht blockiert.
## Die Felder befüllen
| Feld | Bedeutung |
| --------------- | ------------------------------------------------------------------------------------------------------ |
| name | Anzeigename. Kann später geändert werden |
| key | Der stabile Bezeichner, unter dem die Ergebnisse angezeigt werden, z. B. `code_assistant_quality_gate` |
| version | Eine beliebige Versionszeichenkette ohne Leerzeichen, z. B. `1.0.0` |
| result | **score** (0 bis 1), **metric** (eine Zahl mit Einheit) oder **assertion** (bestanden oder nicht) |
| timeout seconds | Standard: 30. Die Sandbox bricht einzelne Läufe nach 60 Sekunden ab |
| labels | Bis zu 20, kommagetrennt. Können später geändert werden |
| condition | Optional. Ein Python-Ausdruck; die Evaluierung läuft nur für Sessions, bei denen er `True` ergibt |
Verwende die Bedingung, um eine Evaluierung auf die dafür vorgesehenen Agents und Umgebungen einzuschränken:
```python theme={null}
session.agent_id == "code-assistant" and session.environment == "production"
```
Key, Version, Ergebnistyp, Bedingung und Code sind nach dem Deployment unveränderlich: Um sie zu ändern, muss eine neue Version veröffentlicht werden. Name, Labels und der Aktivierungsstatus bleiben bearbeitbar.
## Den Code selbst schreiben
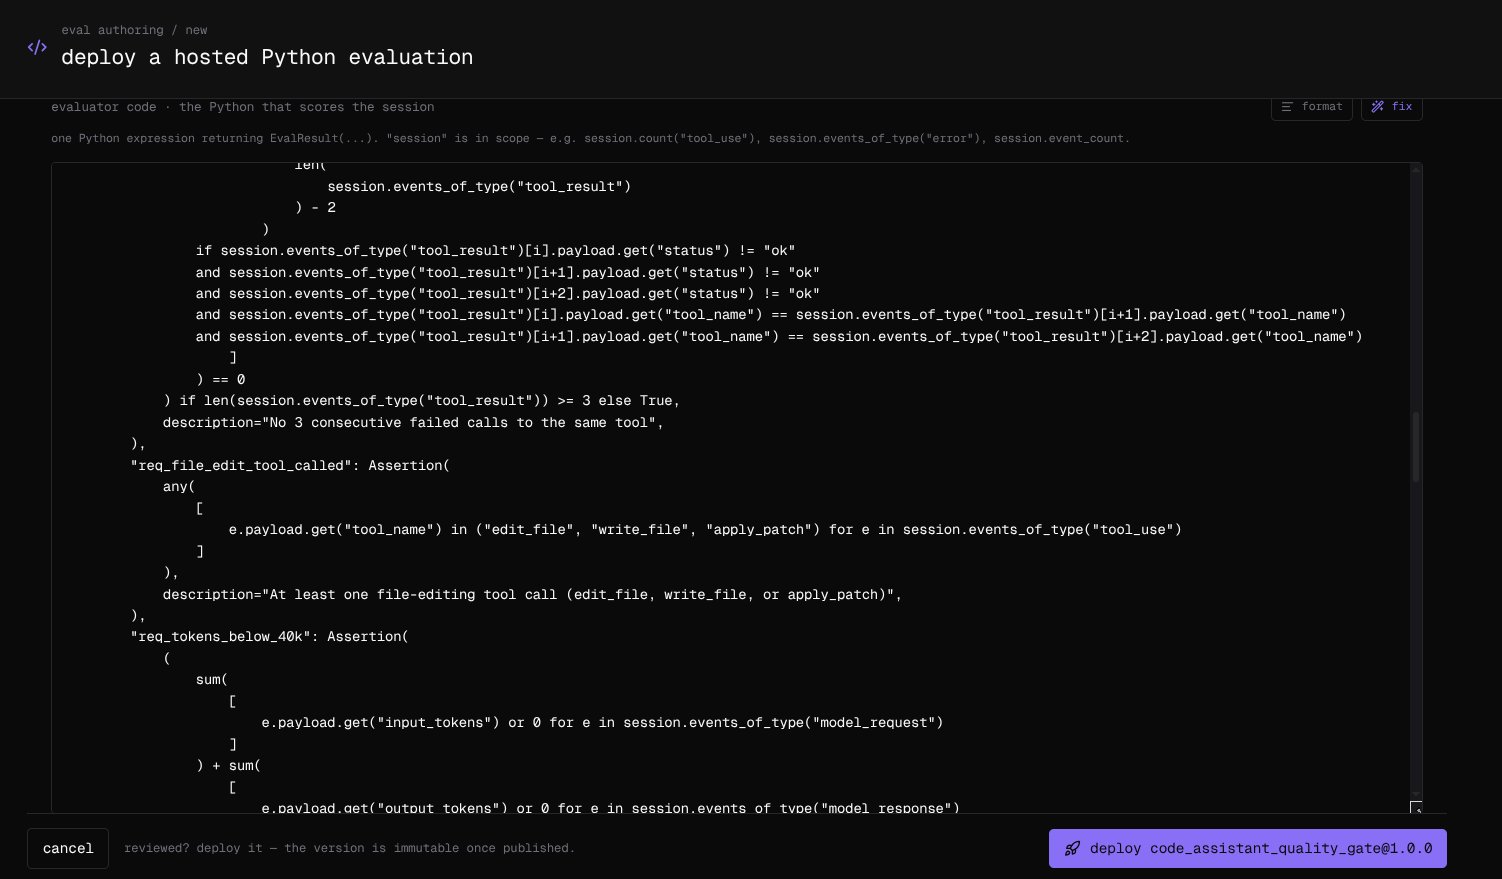
Der **evaluator code** ist ein einzelner Python-Ausdruck, der `EvalResult(...)` zurückgibt, wobei `session` im Scope verfügbar ist. Dieses Beispiel bewertet den Anteil der Tool-Ergebnisse, die mit ok zurückgekehrt sind:
```python theme={null}
EvalResult(
score=Score(
len([e for e in session.events_of_type("tool_result") if e.payload.get("status") == "ok"])
/ max(1, session.count("tool_result"))
),
metrics={"tool_calls": Metric(session.count("tool_use"), unit="calls")},
reasoning="Share of tool results that came back ok.",
)
```
Ein Ergebnis beginnt mit dem eigenen Key der Evaluierung, im deklarierten Typ: `score=` für eine Score-Evaluierung, oder ein `metrics`- bzw. `assertions`-Eintrag mit dem Namen des Keys für eine Metrik- oder Assertion-Evaluierung. Weitere Metriken und Assertions können mitsenden — bis zu 25 Ergebnisse pro Lauf.
| Im Scope | Stellt bereit |
| ------------- | --------------------------------------------------------------------------------------------------------------------------------------------------------- |
| `session` | `session_id`, `agent_id`, `environment`, `started_at`, `ended_at`, `event_count` und `events`, sowie `count(event_type)` und `events_of_type(event_type)` |
| Jedes Event | `id`, `ts`, `event_type` und `payload` |
| Ergebnistypen | `EvalResult`, `Score`, `Metric`, `Assertion` und `ConditionResult` für eine Bedingung |
| Builtins | `abs`, `all`, `any`, `bool`, `dict`, `float`, `int`, `len`, `list`, `max`, `min`, `range`, `round`, `set`, `sorted`, `str`, `sum`, `tuple` |
Nichts anderes ist erreichbar: keine Imports und keine Attribute über die Session-Daten sowie einfache String- und Dictionary-Methoden wie `get`, `lower` und `split` hinaus, die aufgerufen werden müssen anstatt nur referenziert zu werden. Payload-Schlüssel sind das, was deine Agents senden — `status` oben ist nur ein Beispiel — lies sie daher von einer echten Session ab. **format** formatiert den Code, **fix** beauftragt den Assistenten, ihn zu reparieren. Der Code kann bis zu 128 KiB groß sein, die Bedingung bis zu 16 KiB.
 ## Im eigenen Worker schreiben
Wenn eine Evaluierung ein Modell, ein Paket, ein Secret oder das Netzwerk benötigt, schreibe sie mit dem [Evaluator SDK](/de/reference/evaluator-sdk) und führe sie auf deiner eigenen Infrastruktur aus. Sie verwendet dieselben Ergebnistypen, und ihre Ergebnisse erscheinen neben gehosteten Evaluierungen, gekennzeichnet mit **customer**:
```python theme={null}
@app.eval("answer_relevance", version="judge-v1", labels=["llm_judge"], timeout_seconds=30)
async def answer_relevance(session):
value, reasoning = await ask_judge(session) # your LLM call: a 0-1 score and why
return EvalResult(score=Score(value, passed=value >= 0.7), reasoning=reasoning)
```