> ## Documentation Index
> Fetch the complete documentation index at: https://docs.befailproof.ai/llms.txt
> Use this file to discover all available pages before exploring further.
# Écrire une évaluation
> Décrivez ce que vous souhaitez mesurer et laissez l'assistant générer une évaluation Python hébergée, ou écrivez le code vous-même. Les juges LLM s'exécutent dans votre propre worker.
Les évaluations hébergées sont de petits scripts Python déterministes, écrits dans le tableau de bord et exécutés sur la flotte d'évaluateurs de Failproof AI. La logique plus lourde — un juge LLM, un package, un secret, un appel réseau — s'exécute plutôt dans [votre propre worker](#l-exécuter-dans-votre-propre-worker).
## Générer une ébauche à partir d'une description
1. Accédez à **Analyze → eval authoring** et sélectionnez **new eval**.
2. Décrivez ce que vous souhaitez mesurer en langage courant, ou choisissez **start from an example…**, puis sélectionnez **draft**.
3. Examinez les champs et le code généré, puis [testez-le](/fr/evaluations/test) et [déployez-le](/fr/evaluations/deploy).
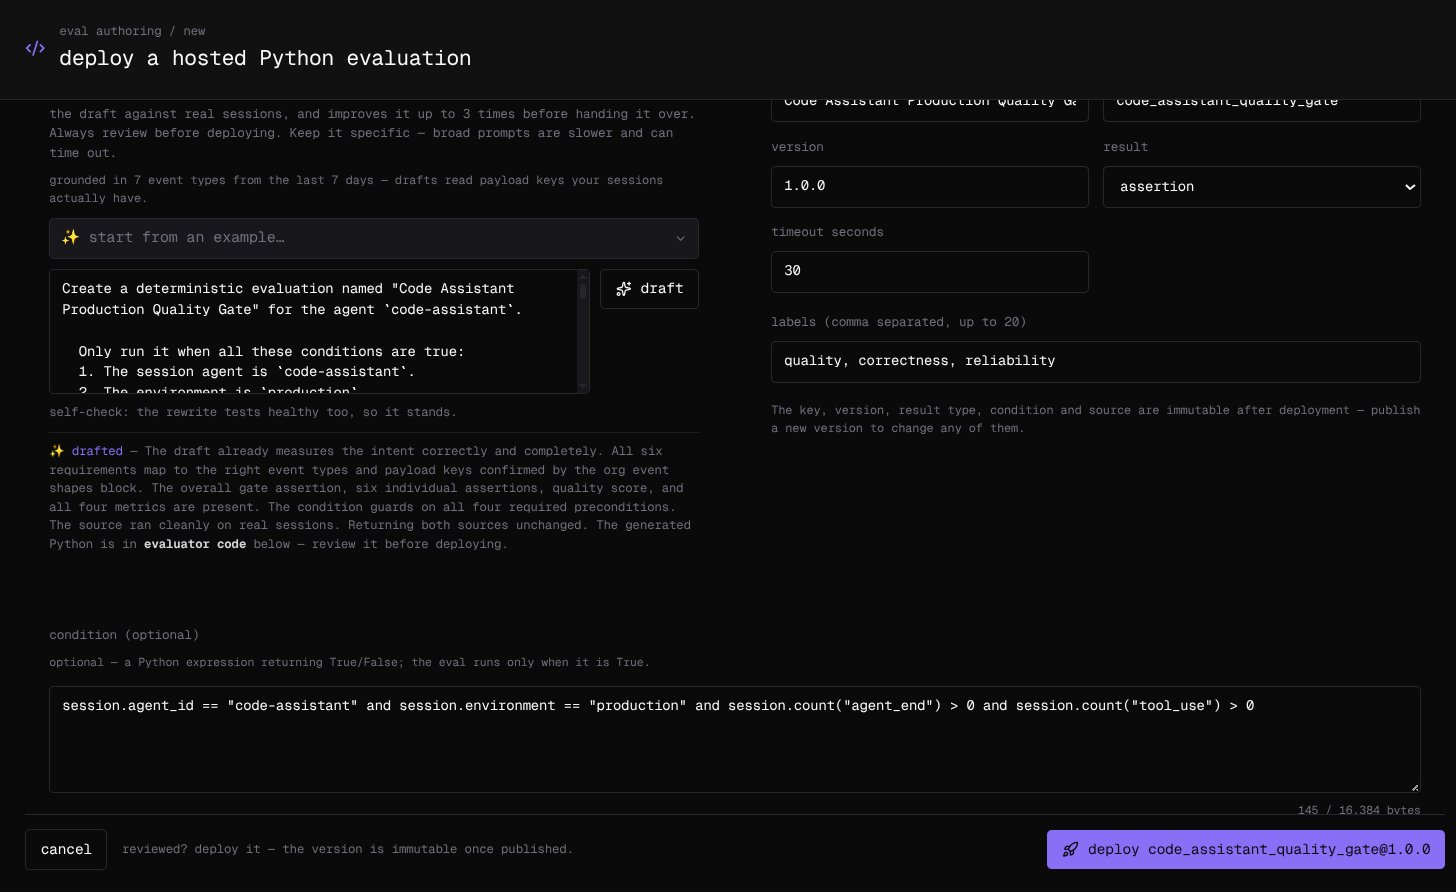 L'ébauche s'appuie sur les événements propres à votre organisation : la page lit les clés de payload que vos sessions ont transportées au cours des sept derniers jours, de sorte que le code utilise des clés qui existent réellement plutôt que des suppositions. Avant de vous remettre l'ébauche, l'assistant la teste sur jusqu'à cinq de vos sessions récentes, corrige tout ce qu'il peut prouver être cassé — jusqu'à trois itérations — et vérifie une fois que le code mesure bien ce que vous avez demandé. Soyez précis dans votre description : les prompts trop larges sont plus lents et peuvent expirer. Examinez le code dans tous les cas ; le déploiement n'est jamais bloqué.
## Configurer les champs
| Champ | Description |
| --------------- | -------------------------------------------------------------------------------------------------------- |
| name | Ce que les utilisateurs voient. Modifiable ultérieurement |
| key | L'identifiant stable sous lequel ses résultats sont regroupés, par exemple `code_assistant_quality_gate` |
| version | Toute chaîne de version sans espaces, par exemple `1.0.0` |
| result | **score** (0 à 1), **metric** (un nombre avec une unité), ou **assertion** (réussie ou non) |
| timeout seconds | 30 par défaut. Le bac à sable arrête toute exécution individuelle à 60 secondes |
| labels | Jusqu'à 20, séparées par des virgules. Modifiable ultérieurement |
| condition | Facultatif. Une expression Python ; l'évaluation ne s'exécute que sur les sessions où elle vaut `True` |
Utilisez la condition pour cibler une évaluation sur les agents et environnements auxquels elle est destinée :
```python theme={null}
session.agent_id == "code-assistant" and session.environment == "production"
```
La clé, la version, le type de résultat, la condition et le code sont immuables une fois déployés : pour en modifier l'un d'eux, publiez une nouvelle version. Le nom, les labels et l'état d'activation restent modifiables.
## Écrire le code vous-même
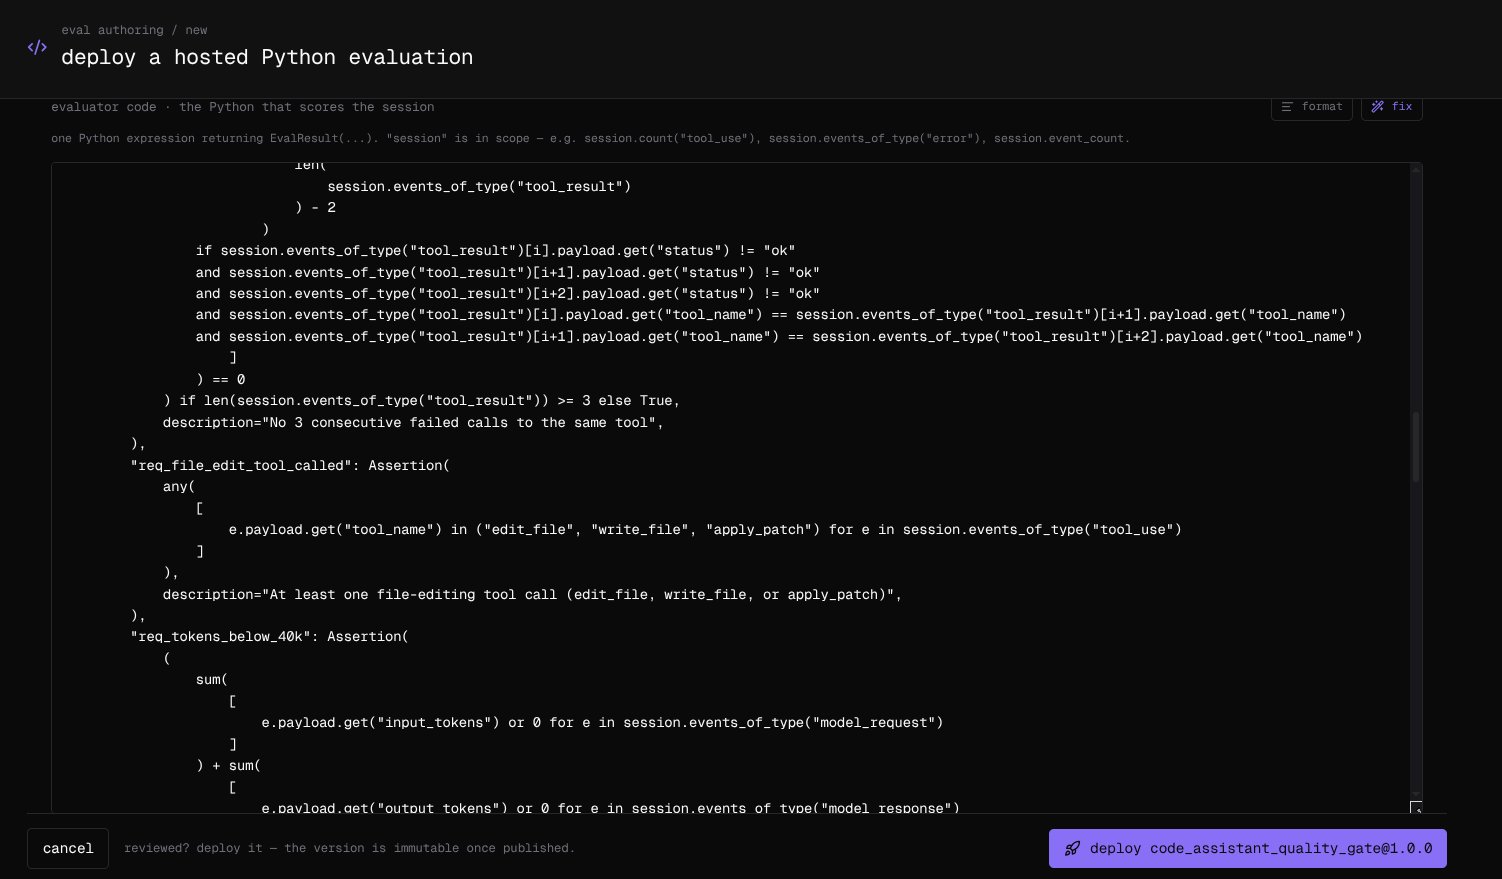
Le **evaluator code** est une expression Python unique qui retourne `EvalResult(...)`, avec `session` dans la portée. Celle-ci calcule la proportion de résultats d'outils retournés avec le statut ok :
```python theme={null}
EvalResult(
score=Score(
len([e for e in session.events_of_type("tool_result") if e.payload.get("status") == "ok"])
/ max(1, session.count("tool_result"))
),
metrics={"tool_calls": Metric(session.count("tool_use"), unit="calls")},
reasoning="Share of tool results that came back ok.",
)
```
Un résultat commence par la clé propre à l'évaluation, dans son type déclaré : `score=` pour une évaluation de score, ou une entrée `metrics` ou `assertions` portant le nom de la clé pour une évaluation de métrique ou d'assertion. D'autres métriques et assertions peuvent l'accompagner, jusqu'à 25 résultats par exécution.
| Dans la portée | Vous donne accès à |
| ------------------ | ------------------------------------------------------------------------------------------------------------------------------------------------------------ |
| `session` | `session_id`, `agent_id`, `environment`, `started_at`, `ended_at`, `event_count`, et `events`, ainsi que `count(event_type)` et `events_of_type(event_type)` |
| Chaque événement | `id`, `ts`, `event_type`, et `payload` |
| Types de résultats | `EvalResult`, `Score`, `Metric`, `Assertion`, et `ConditionResult` pour une condition |
| Builtins | `abs`, `all`, `any`, `bool`, `dict`, `float`, `int`, `len`, `list`, `max`, `min`, `range`, `round`, `set`, `sorted`, `str`, `sum`, `tuple` |
Rien d'autre n'est accessible : pas d'imports, et aucun attribut au-delà des données de session et des méthodes de chaînes et de dictionnaires courantes comme `get`, `lower` et `split`, qui doivent être appelées et non simplement référencées. Les clés de payload correspondent à ce que vos agents envoient — `status` ci-dessus n'est qu'un exemple — lisez-les donc depuis une vraie session. **format** met en forme le code et **fix** demande à l'assistant de le corriger. Le code peut faire jusqu'à 128 Kio, et la condition jusqu'à 16 Kio.
 ## L'exécuter dans votre propre worker
Lorsqu'une évaluation nécessite un modèle, un package, un secret ou le réseau, écrivez-la avec l'[Evaluator SDK](/fr/reference/evaluator-sdk) et exécutez-la sur votre propre infrastructure. Elle utilise les mêmes types de résultats, et ses résultats apparaissent à côté des évaluations hébergées, avec le tag **customer** :
```python theme={null}
@app.eval("answer_relevance", version="judge-v1", labels=["llm_judge"], timeout_seconds=30)
async def answer_relevance(session):
value, reasoning = await ask_judge(session) # your LLM call: a 0-1 score and why
return EvalResult(score=Score(value, passed=value >= 0.7), reasoning=reasoning)
```