> ## Documentation Index
> Fetch the complete documentation index at: https://docs.befailproof.ai/llms.txt
> Use this file to discover all available pages before exploring further.
# כתוב הערכה
> תאר מה למדוד והנח לעוזר לעצב הערכת Python מתארחת, או כתוב את הקוד בעצמך. שופטי LLM פועלים בעובד שלך.
הערכות מתארחות הן Python קטנות וקביעות, שנכתבות בלוח הבקרה ופועלות בחfleet המעריכים של Failproof AI. לוגיקה כבדה יותר — שופט LLM, חבילה, סוד, קריאת רשת — פועלת ב[עובד שלך](#כתוב-זאת-בעובד-שלך) במקום זאת.
## ערוך זאת מתיאור
1. עבור ל**Analyze → eval authoring** ובחר **new eval**.
2. תאר מה למדוד באנגלית פשוטה, או בחר מ**start from an example…**, ובחר **draft**.
3. בדוק את השדות ואת הקוד שהוא ממלא, ואז [בדוק אותו](/he/evaluations/test) ו[פרוס אותו](/he/evaluations/deploy).
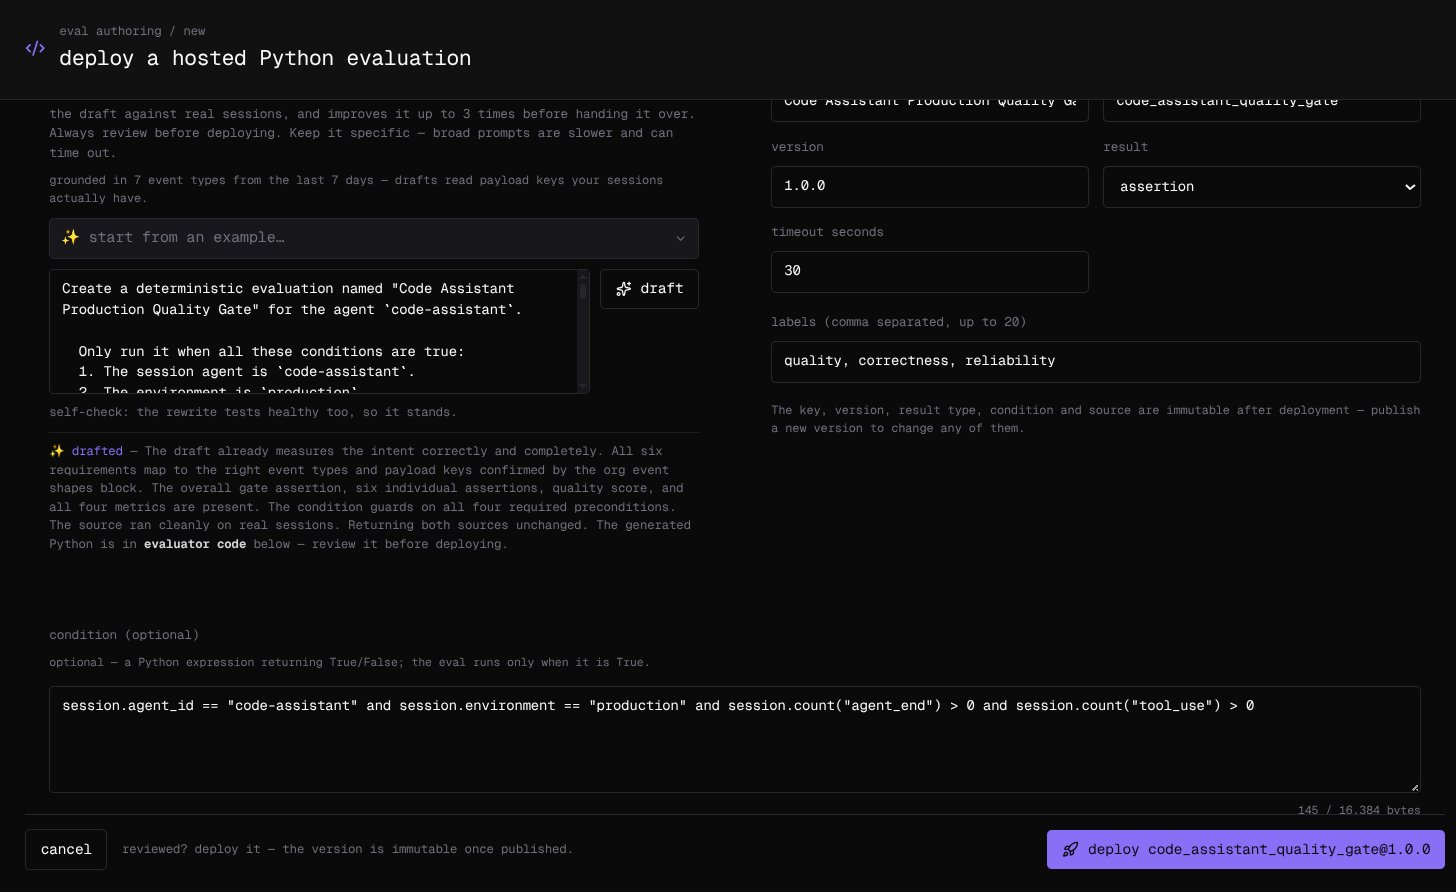 העיצוב מעוגן באירועי הארגון שלך: הדף קורא אילו מפתחות payload הנשיאות שלך נשאו במהלך שבעת הימים האחרונים, כך שהקוד קורא מפתחות שקיימים במקום לנחש. לפני מסירת העיצוב, העוזר בוחן אותו מול עד חמש מהסשנים האחרונים שלך, מתקן כל דבר שהוא יכול להוכיח שהוא שבור — עד שלוש סבבים — ובודק פעם אחת שהקוד מודד מה ביקשת. שמור על התיאור ספציפי: הנושאים הרחבים איטיים יותר ויכולים להיתקע. בדוק את הקוד כך או כך; הפריסה לעולם לא חסומה.
## הגדר את השדות
| שדה | מה זה |
| --------------- | ---------------------------------------------------------------------------- |
| name | מה אנשים רואים. ניתן לעריכה מאוחר יותר |
| key | המזהה היציב שתוצאותיו מתוכננות תחתיו, כגון `code_assistant_quality_gate` |
| version | כל מחרוזת גרסה ללא רווחים, כגון `1.0.0` |
| result | **score** (0 עד 1), **metric** (מספר עם יחידה), או **assertion** (עבר או לא) |
| timeout seconds | ברירת מחדל 30. ה-sandbox עוצר כל ריצה יחידה ב-60 |
| labels | עד 20, מופרדים בפסיקים. ניתן לעריכה מאוחר יותר |
| condition | אופציונלי. ביטוי Python; ההערכה פועלת רק בסשנים שבהם היא `True` |
השתמש בתנאי כדי להגביל הערכה לעוזרים וסביבות המיועדות לה:
```python theme={null}
session.agent_id == "code-assistant" and session.environment == "production"
```
המפתח, הגרסה, סוג התוצאה, התנאי והקוד אינם ניתנים לשינוי לאחר הפריסה: כדי לשנות כל אחד מהם, פרסם גרסה חדשה. השם, התוויות, והאם היא מופעלת יישארו ניתנים לעריכה.
## כתוב את הקוד בעצמך
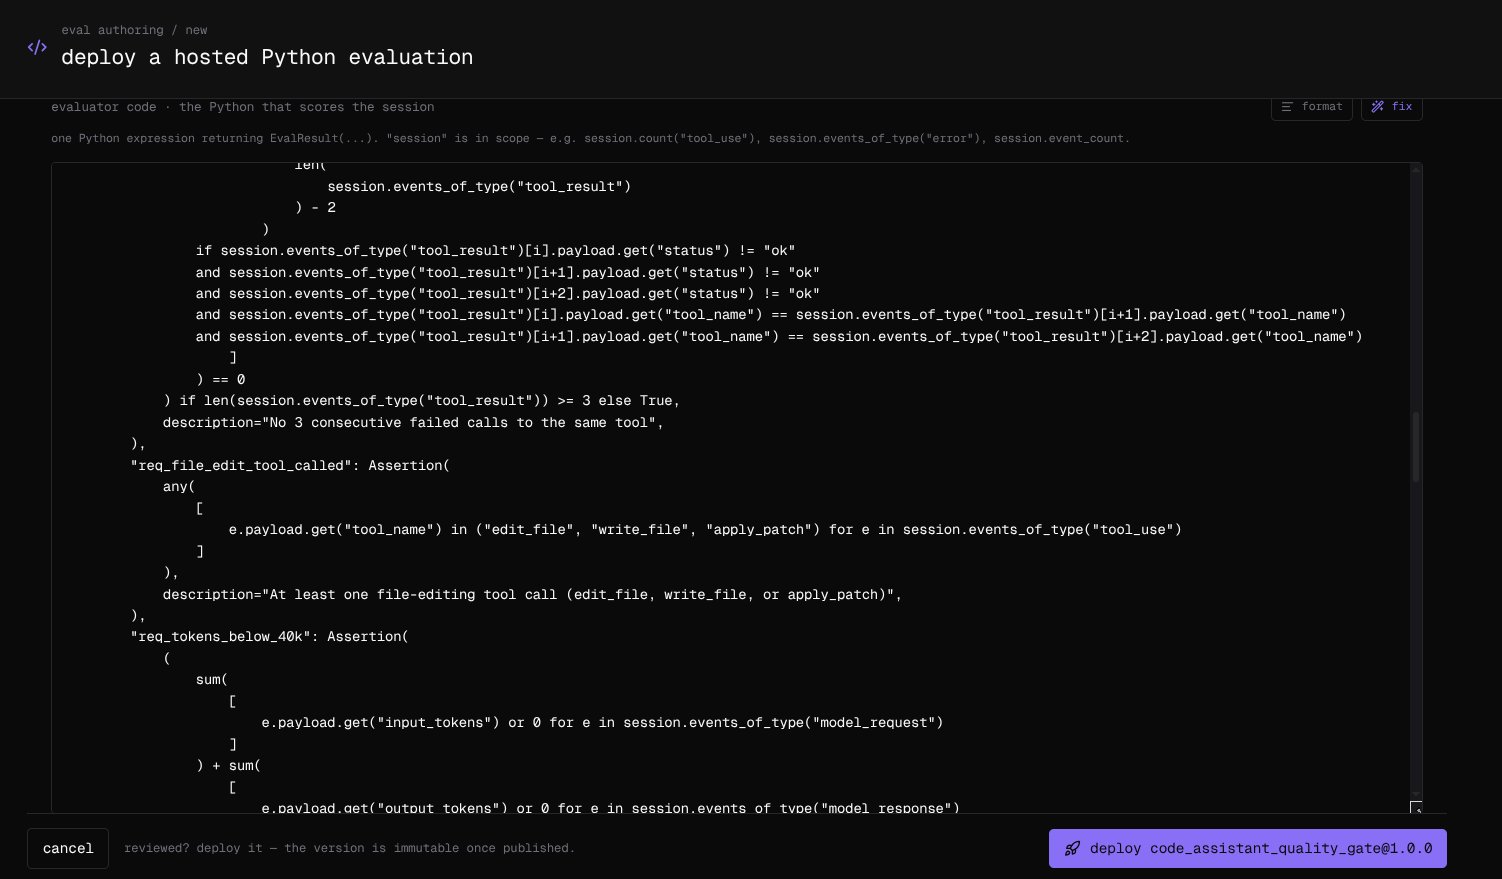
**קוד ה-evaluator** הוא ביטוי Python אחד שמחזיר `EvalResult(...)`, עם `session` בהיקף. זה מדרג את חלק תוצאות הכלים שחזרו בסדר:
```python theme={null}
EvalResult(
score=Score(
len([e for e in session.events_of_type("tool_result") if e.payload.get("status") == "ok"])
/ max(1, session.count("tool_result"))
),
metrics={"tool_calls": Metric(session.count("tool_use"), unit="calls")},
reasoning="Share of tool results that came back ok.",
)
```
תוצאה מובילה עם מפתח ההערכה שלה, בסוג המוצהר שלו: `score=` להערכת ניקוד, או ערך `metrics` או `assertions` בשם המפתח להערכת מטרי או קביעה. מטריקות ותביעות אחרות רוכבות איתו, עד 25 תוצאות בריצה.
| בהיקף | נותן לך |
| ---------- | ------------------------------------------------------------------------------------------------------------------------------------------------------- |
| `session` | `session_id`, `agent_id`, `environment`, `started_at`, `ended_at`, `event_count`, ו-`events`, בתוספת `count(event_type)` ו-`events_of_type(event_type)` |
| כל אירוע | `id`, `ts`, `event_type`, ו-`payload` |
| סוגי תוצאה | `EvalResult`, `Score`, `Metric`, `Assertion`, ו-`ConditionResult` לתנאי |
| Builtins | `abs`, `all`, `any`, `bool`, `dict`, `float`, `int`, `len`, `list`, `max`, `min`, `range`, `round`, `set`, `sorted`, `str`, `sum`, `tuple` |
כלום אחר אינו זמין: אין ייבואים, וללא תכונות מעבר לנתוני הסשן וטופל טקסט ושיטות מילון רגילות כמו `get`, `lower`, ו-`split`, שיש להם להיקרא במקום להיות מופנים. מפתחות payload הם כל מה שהעוזרים שלך שולחים — `status` לעיל הוא רק דוגמה — אז קרא אותם מסשן אמיתי. **format** מסדר את הקוד ו-**fix** מבקש מהעוזר לתקן אותו. הקוד יכול להיות עד 128 KiB, והתנאי עד 16 KiB.
 ## כתוב זאת בעובד שלך
כאשר הערכה צריכה מודל, חבילה, סוד, או רשת, כתוב אותה עם ה-[Evaluator SDK](/he/reference/evaluator-sdk) והפעל אותה בתשתית שלך. היא משתמשת באותם סוגי תוצאה, ותוצאותיה מופיעות לצד אלו המתארחות, מתויגות **customer**:
```python theme={null}
@app.eval("answer_relevance", version="judge-v1", labels=["llm_judge"], timeout_seconds=30)
async def answer_relevance(session):
value, reasoning = await ask_judge(session) # your LLM call: a 0-1 score and why
return EvalResult(score=Score(value, passed=value >= 0.7), reasoning=reasoning)
```