> ## Documentation Index
> Fetch the complete documentation index at: https://docs.befailproof.ai/llms.txt
> Use this file to discover all available pages before exploring further.
# Scrivi una valutazione
> Descrivi cosa misurare e lascia che l'assistente rediga una valutazione Python ospitata, oppure scrivi il codice tu stesso. I giudici LLM vengono eseguiti nel tuo worker.
Le valutazioni ospitate sono piccoli Python deterministici, scritti nel dashboard ed eseguiti sulla flotta di valutatori di Failproof AI. La logica più complessa — un giudice LLM, un pacchetto, un segreto, una chiamata di rete — viene eseguita nel [tuo worker](#scrivi-nel-tuo-worker).
## Redila da una descrizione
1. Vai a **Analyze → eval authoring** e seleziona **new eval**.
2. Descrivi cosa misurare in inglese semplice, oppure scegli da **start from an example…**, e seleziona **draft**.
3. Rivedi i campi e il codice che compila, quindi [testalo](/it/evaluations/test) e [distribuiscilo](/it/evaluations/deploy).
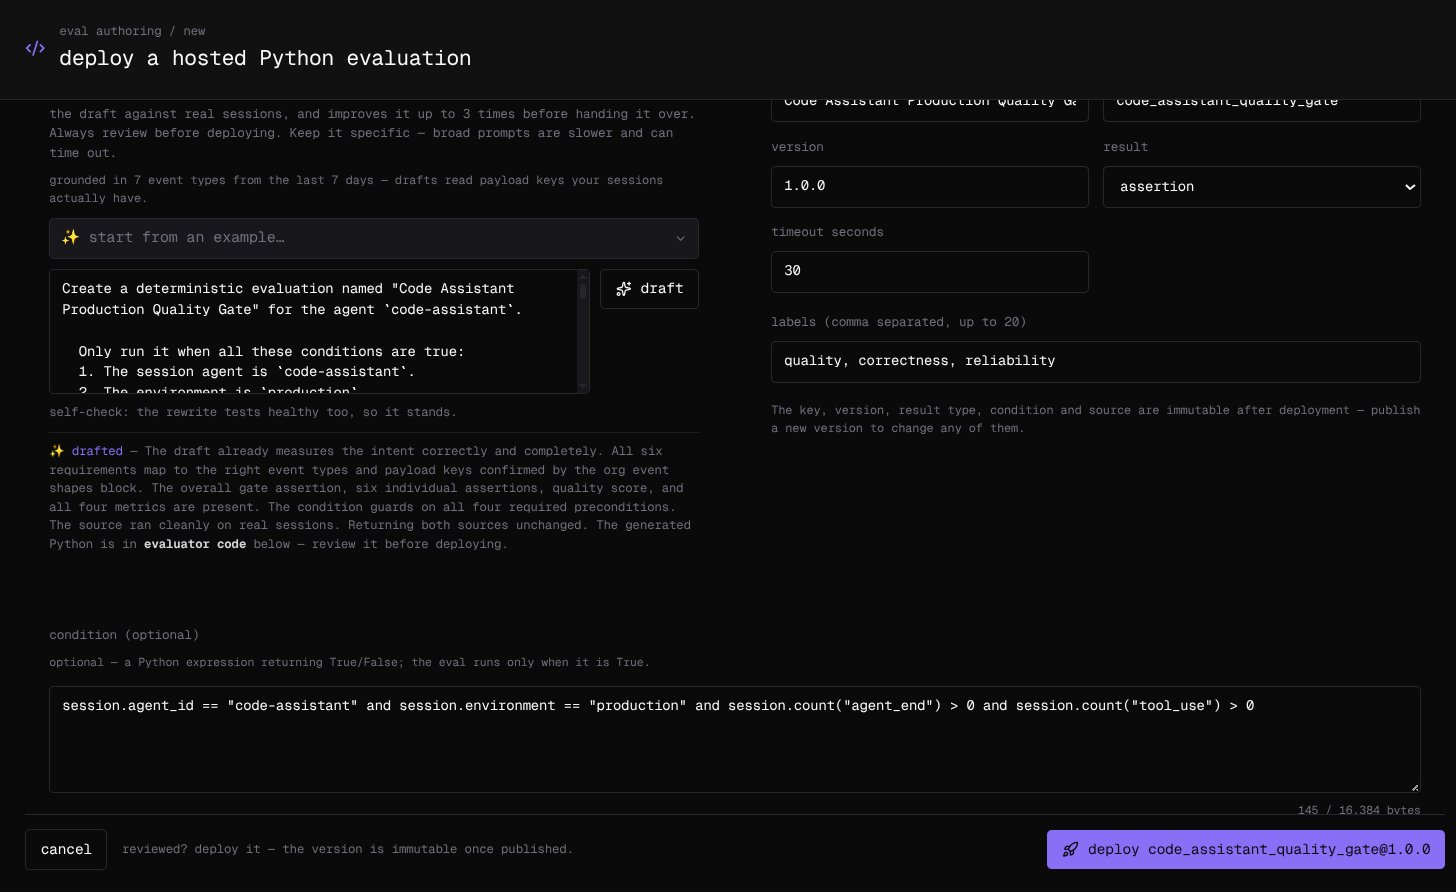 La bozza è radicata negli eventi della tua organizzazione: la pagina legge quali chiavi di payload le tue sessioni hanno trasportato negli ultimi sette giorni, quindi il codice legge chiavi che esistono piuttosto che indovinare. Prima di consegnare la bozza, l'assistente la testa su fino a cinque delle tue sessioni recenti, ripara tutto ciò che può provare sia rotto — per un massimo di tre cicli — e controlla una volta che il codice misuri quello che hai chiesto. Mantieni la descrizione specifica: i prompt ampi sono più lenti e possono andare in timeout. Rivedi il codice comunque; la distribuzione non è mai bloccata.
## Imposta i campi
| Campo | Cos'è |
| --------------- | -------------------------------------------------------------------------------------------------------------------- |
| name | Quello che vedono le persone. Modificabile in seguito |
| key | L'identificatore stabile sotto il quale i suoi risultati vengono graficati, ad esempio `code_assistant_quality_gate` |
| version | Qualsiasi stringa di versione senza spazi, ad esempio `1.0.0` |
| result | **score** (da 0 a 1), **metric** (un numero con un'unità), o **assertion** (riuscito o meno) |
| timeout seconds | Predefinito 30. La sandbox interrompe qualsiasi singola esecuzione a 60 |
| labels | Fino a 20, separate da virgole. Modificabili in seguito |
| condition | Opzionale. Un'espressione Python; la valutazione viene eseguita solo sulle sessioni in cui è `True` |
Usa la condition per limitare una valutazione agli agenti e agli ambienti per cui è destinata:
```python theme={null}
session.agent_id == "code-assistant" and session.environment == "production"
```
La key, la version, il tipo di result, la condition e il codice sono immutabili una volta distribuiti: per modificarne uno qualsiasi, pubblica una nuova versione. Il name, i labels e se è abilitato rimangono modificabili.
## Scrivi il codice tu stesso
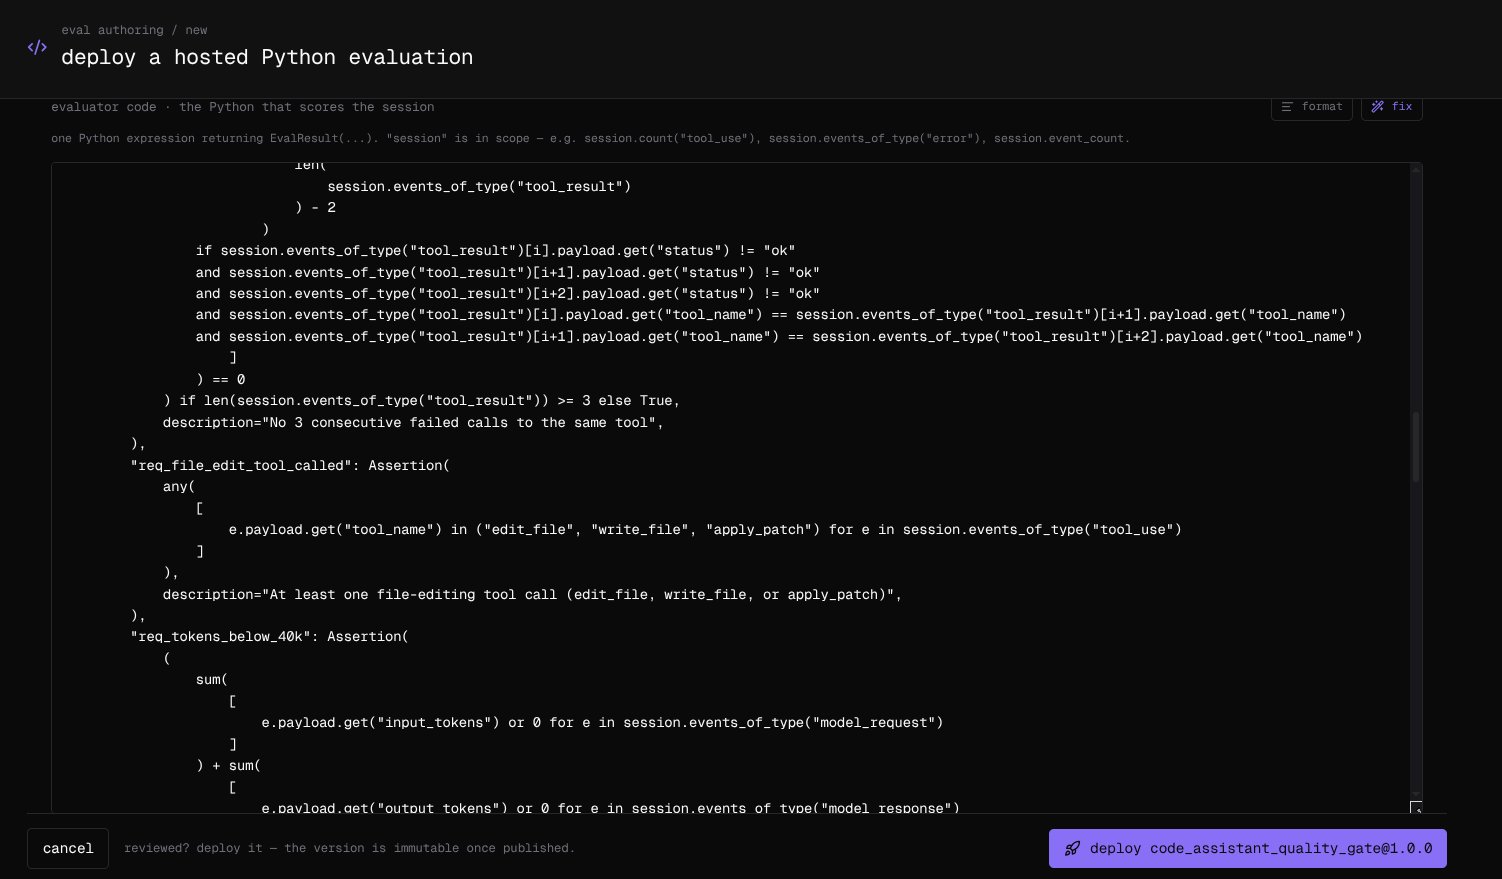
Il **codice evaluator** è un'unica espressione Python che restituisce `EvalResult(...)`, con `session` in ambito. Questo calcola la quota di risultati di strumenti tornati ok:
```python theme={null}
EvalResult(
score=Score(
len([e for e in session.events_of_type("tool_result") if e.payload.get("status") == "ok"])
/ max(1, session.count("tool_result"))
),
metrics={"tool_calls": Metric(session.count("tool_use"), unit="calls")},
reasoning="Share of tool results that came back ok.",
)
```
Un risultato inizia con la propria key della valutazione, nel suo tipo dichiarato: `score=` per una valutazione score, oppure una voce `metrics` o `assertions` denominata dalla key per una valutazione metric o assertion. Altre metriche e assertion la accompagnano, fino a 25 risultati in un'esecuzione.
| In ambito | Ti dà |
| ----------------- | ---------------------------------------------------------------------------------------------------------------------------------------------------- |
| `session` | `session_id`, `agent_id`, `environment`, `started_at`, `ended_at`, `event_count`, e `events`, più `count(event_type)` e `events_of_type(event_type)` |
| Ogni event | `id`, `ts`, `event_type`, e `payload` |
| Tipi di risultato | `EvalResult`, `Score`, `Metric`, `Assertion`, e `ConditionResult` per una condition |
| Builtins | `abs`, `all`, `any`, `bool`, `dict`, `float`, `int`, `len`, `list`, `max`, `min`, `range`, `round`, `set`, `sorted`, `str`, `sum`, `tuple` |
Nient'altro è raggiungibile: nessun import, e nessun attributo oltre i dati della sessione e i metodi plain string e dictionary come `get`, `lower`, e `split`, che devono essere chiamati piuttosto che referenziati. Le chiavi di payload sono qualunque cosa i tuoi agenti inviino — `status` sopra è solo un esempio — quindi leggile da una sessione reale. **format** ordina il codice e **fix** chiede all'assistente di ripararlo. Il codice può essere fino a 128 KiB, e la condition fino a 16 KiB.
 ## Scrivi nel tuo worker
Quando una valutazione ha bisogno di un modello, un pacchetto, un segreto, o la rete, scrivila con l'[Evaluator SDK](/it/reference/evaluator-sdk) ed eseguila sulla tua infrastruttura. Usa gli stessi tipi di risultato, e i suoi risultati appaiono accanto a quelli ospitati, etichettati **customer**:
```python theme={null}
@app.eval("answer_relevance", version="judge-v1", labels=["llm_judge"], timeout_seconds=30)
async def answer_relevance(session):
value, reasoning = await ask_judge(session) # your LLM call: a 0-1 score and why
return EvalResult(score=Score(value, passed=value >= 0.7), reasoning=reasoning)
```