> ## Documentation Index
> Fetch the complete documentation index at: https://docs.befailproof.ai/llms.txt
> Use this file to discover all available pages before exploring further.
# 評価を作成する
> 測定内容を説明してアシスタントにホスト型Python評価の下書きを作成させるか、コードを自分で記述します。LLMジャッジはお客様自身のワーカー上で実行されます。
ホスト型評価は、ダッシュボードで記述してFailproof AIのエバリュエーターフリート上で実行される、小さな決定論的なPythonコードです。より重い処理(LLMジャッジ、パッケージ、シークレット、ネットワーク呼び出しなど)は、代わりに[お客様自身のワーカー](#お客様自身のワーカーで記述する)上で実行されます。
## 説明から下書きを作成する
1. **Analyze → eval authoring** に移動し、**new eval** を選択します。
2. 測定内容を平易な英語で説明するか、**start from an example…** から選択して、**draft** を選択します。
3. フィールドと自動入力されたコードを確認し、[テスト](/ja/evaluations/test)して[デプロイ](/ja/evaluations/deploy)します。
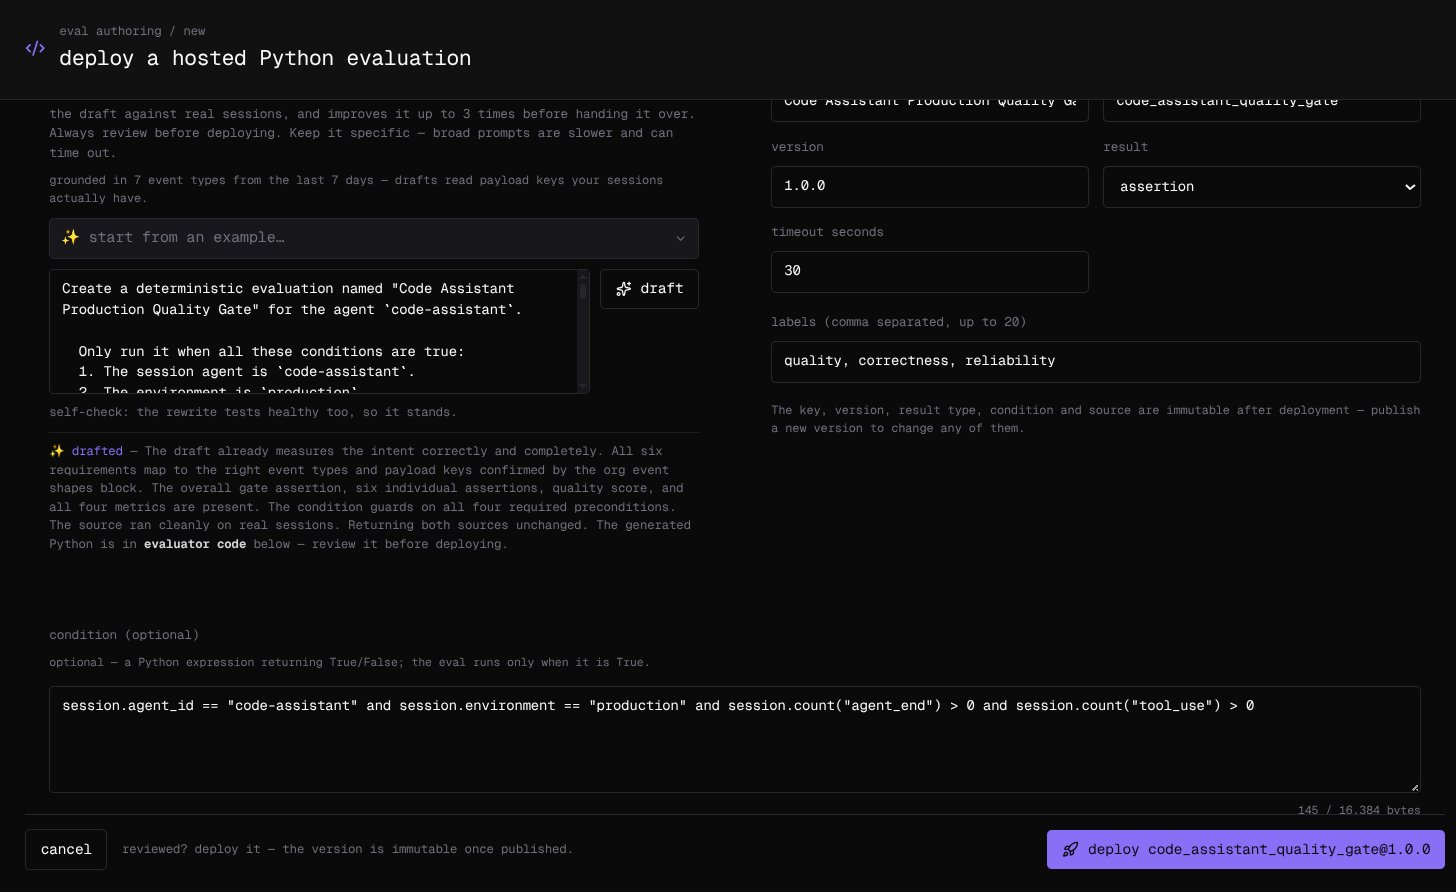 下書きは組織独自のイベントに基づいています。このページは過去7日間のセッションで使用されたペイロードキーを読み取るため、コードは推測ではなく実際に存在するキーを参照します。下書きを渡す前に、アシスタントは最大5件の最近のセッションに対してテストを行い、最大3ラウンドで修正可能な問題を修正し、コードが要求された内容を測定しているか一度確認します。説明は具体的に記述してください。広範なプロンプトは処理が遅くタイムアウトする場合があります。いずれの場合もコードをレビューしてください。デプロイがブロックされることはありません。
## フィールドを設定する
| フィールド | 内容 |
| --------------- | -------------------------------------------------------- |
| name | 表示される名前。後から編集可能 |
| key | 結果をチャートで示す際の安定した識別子(例:`code_assistant_quality_gate`) |
| version | スペースなしの任意のバージョン文字列(例:`1.0.0`) |
| result | **score**(0〜1)、**metric**(単位付きの数値)、または **assertion**(合否) |
| timeout seconds | デフォルトは30。サンドボックスは1回の実行を60秒で停止 |
| labels | 最大20件、カンマ区切り。後から編集可能 |
| condition | 任意。Python式。`True` となるセッションのみで評価が実行される |
conditionを使用して、評価を対象とするエージェントおよび環境にスコープを絞り込みます:
```python theme={null}
session.agent_id == "code-assistant" and session.environment == "production"
```
key、version、result type、condition、コードはデプロイ後は変更不可です。これらを変更する場合は、新しいバージョンを公開してください。name、labels、および有効/無効の状態は引き続き編集可能です。
## コードを自分で記述する
**evaluator code** は `EvalResult(...)` を返す1つのPython式で、スコープ内に `session` があります。以下の例は、ステータスがokで返ってきたツール結果の割合を採点します:
```python theme={null}
EvalResult(
score=Score(
len([e for e in session.events_of_type("tool_result") if e.payload.get("status") == "ok"])
/ max(1, session.count("tool_result"))
),
metrics={"tool_calls": Metric(session.count("tool_use"), unit="calls")},
reasoning="Share of tool results that came back ok.",
)
```
結果は、評価自身のキーを宣言された型でリードします。score評価には `score=`、metric評価またはassertion評価にはキーと同じ名前の `metrics` または `assertions` エントリを使用します。その他のmetricsとassertionsはこれに付随し、1回の実行で最大25件の結果を含められます。
| スコープ内 | 利用できるもの |
| --------- | ----------------------------------------------------------------------------------------------------------------------------------------- |
| `session` | `session_id`、`agent_id`、`environment`、`started_at`、`ended_at`、`event_count`、`events`、および `count(event_type)`、`events_of_type(event_type)` |
| 各イベント | `id`、`ts`、`event_type`、`payload` |
| 結果型 | `EvalResult`、`Score`、`Metric`、`Assertion`、conditionには `ConditionResult` |
| 組み込み関数 | `abs`、`all`、`any`、`bool`、`dict`、`float`、`int`、`len`、`list`、`max`、`min`、`range`、`round`、`set`、`sorted`、`str`、`sum`、`tuple` |
それ以外にはアクセスできません。importは使用できず、セッションデータとプレーンな文字列・辞書メソッド(`get`、`lower`、`split` など、参照ではなく呼び出しが必要)以外の属性も使用できません。ペイロードキーはエージェントが送信する内容によって異なります(上記の `status` はあくまで例です)。実際のセッションから確認してください。**format** はコードを整形し、**fix** はアシスタントに修正を依頼します。コードは最大128 KiB、conditionは最大16 KiBです。
 ## お客様自身のワーカーで記述する
評価にモデル、パッケージ、シークレット、またはネットワークが必要な場合は、[Evaluator SDK](/ja/reference/evaluator-sdk) を使用して記述し、お客様自身のインフラストラクチャ上で実行します。同じ結果型を使用し、その結果はホスト型の結果の隣に **customer** タグ付きで表示されます:
```python theme={null}
@app.eval("answer_relevance", version="judge-v1", labels=["llm_judge"], timeout_seconds=30)
async def answer_relevance(session):
value, reasoning = await ask_judge(session) # your LLM call: a 0-1 score and why
return EvalResult(score=Score(value, passed=value >= 0.7), reasoning=reasoning)
```