> ## Documentation Index
> Fetch the complete documentation index at: https://docs.befailproof.ai/llms.txt
> Use this file to discover all available pages before exploring further.
# 평가 작성하기
> 측정할 내용을 설명하면 어시스턴트가 호스팅된 Python 평가를 초안으로 작성하거나, 직접 코드를 작성할 수 있습니다. LLM 판정자는 사용자 자신의 워커에서 실행됩니다.
호스팅 평가는 간결하고 결정론적인 Python 코드로, 대시보드에서 작성하고 Failproof AI의 평가자 플릿에서 실행됩니다. LLM 판정자, 패키지, 시크릿, 네트워크 호출 등 무거운 로직은 대신 [사용자 자신의 워커](#사용자-자신의-워커에서-작성하기)에서 실행됩니다.
## 설명으로 초안 작성하기
1. **Analyze → eval authoring**으로 이동하여 **new eval**을 선택합니다.
2. 측정할 내용을 일반 영어로 설명하거나 \*\*start from an example…\*\*에서 선택한 후 **draft**를 선택합니다.
3. 필드와 자동으로 채워진 코드를 검토한 다음 [테스트](/ko/evaluations/test)하고 [배포](/ko/evaluations/deploy)합니다.
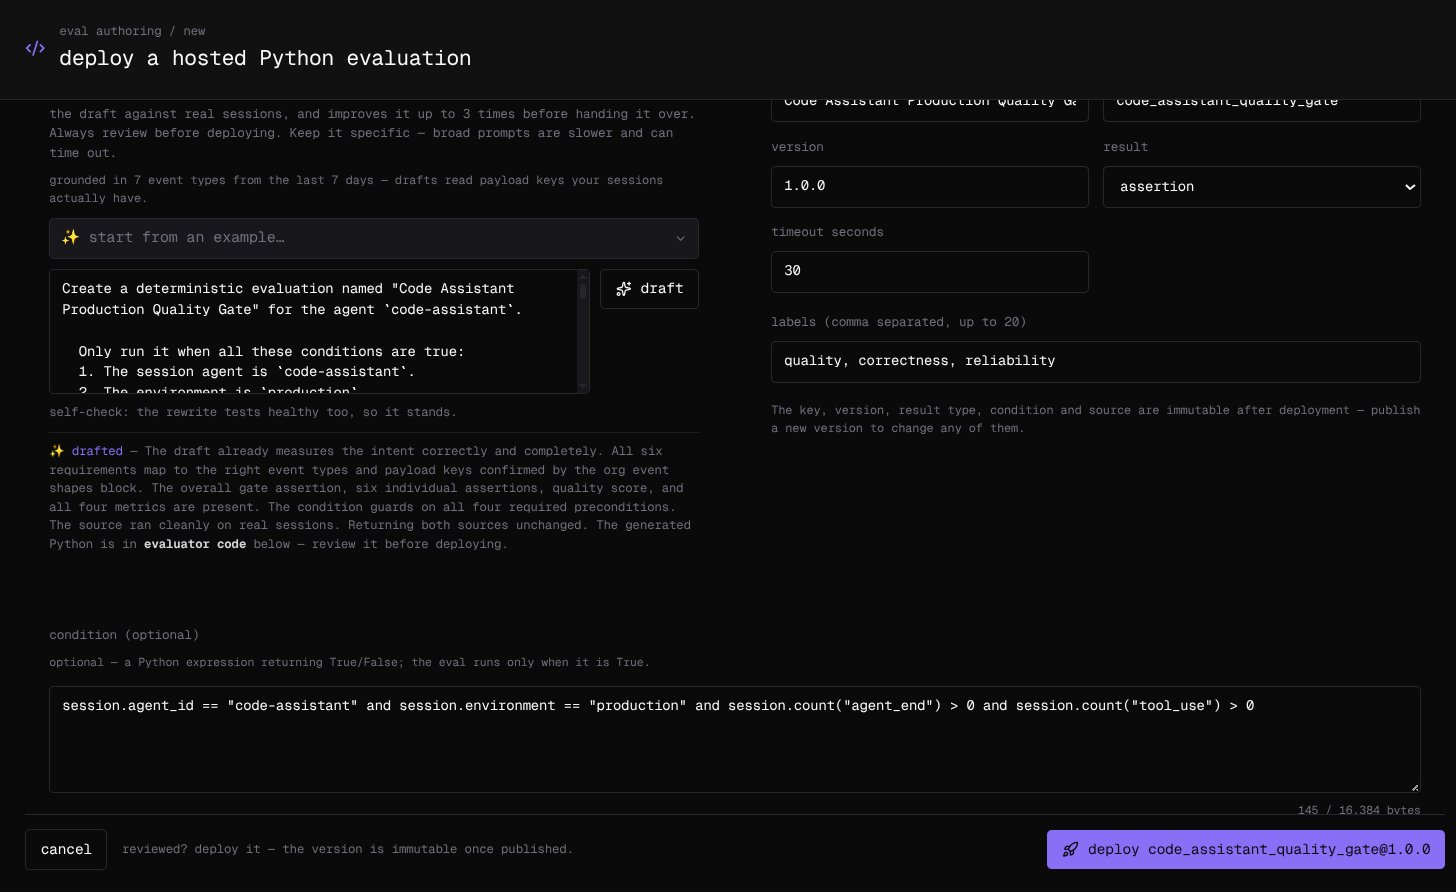 초안은 조직 자체 이벤트를 기반으로 작성됩니다. 해당 페이지는 지난 7일간 세션에서 전달된 페이로드 키를 읽어, 코드가 추측이 아닌 실제로 존재하는 키를 참조하도록 합니다. 초안을 전달하기 전에 어시스턴트는 최근 세션 최대 5개를 대상으로 테스트하고, 최대 3라운드에 걸쳐 오류를 수정한 뒤, 코드가 요청한 내용을 측정하는지 한 번 더 확인합니다. 설명은 구체적으로 작성하세요. 광범위한 프롬프트는 처리 속도가 느리고 타임아웃이 발생할 수 있습니다. 어떤 경우에도 코드를 검토하세요. 배포는 항상 가능합니다.
## 필드 설정하기
| 필드 | 설명 |
| --------------- | ------------------------------------------------------------------ |
| name | 사용자에게 표시되는 이름. 이후 수정 가능 |
| key | 결과가 차트에 표시될 때 사용되는 고정 식별자 (예: `code_assistant_quality_gate`) |
| version | 공백 없는 버전 문자열 (예: `1.0.0`) |
| result | **score** (0\~1), **metric** (단위가 있는 숫자), 또는 **assertion** (통과 여부) |
| timeout seconds | 기본값 30. 샌드박스는 단일 실행을 60초에서 중지합니다 |
| labels | 최대 20개, 쉼표로 구분. 이후 수정 가능 |
| condition | 선택 사항. Python 표현식으로, 해당 표현식이 `True`인 세션에서만 평가가 실행됩니다 |
condition을 사용하면 평가 대상 에이전트와 환경으로 범위를 제한할 수 있습니다:
```python theme={null}
session.agent_id == "code-assistant" and session.environment == "production"
```
키, 버전, 결과 유형, 조건, 코드는 배포 후 변경할 수 없습니다. 이 중 하나라도 변경하려면 새 버전을 게시해야 합니다. 이름, 레이블, 활성화 여부는 계속 수정할 수 있습니다.
## 직접 코드 작성하기
**evaluator code**는 `EvalResult(...)`를 반환하는 단일 Python 표현식이며, 스코프 내에 `session`이 제공됩니다. 아래 예제는 성공적으로 반환된 도구 결과의 비율을 점수로 계산합니다:
```python theme={null}
EvalResult(
score=Score(
len([e for e in session.events_of_type("tool_result") if e.payload.get("status") == "ok"])
/ max(1, session.count("tool_result"))
),
metrics={"tool_calls": Metric(session.count("tool_use"), unit="calls")},
reasoning="Share of tool results that came back ok.",
)
```
결과는 평가 자체의 키를 선두에 두고, 선언된 유형으로 시작합니다. 점수 평가는 `score=`를, 메트릭 또는 어서션 평가는 해당 키 이름의 `metrics` 또는 `assertions` 항목을 사용합니다. 그 외 메트릭과 어서션은 함께 포함될 수 있으며, 한 번 실행에 최대 25개의 결과를 담을 수 있습니다.
| 스코프 내 항목 | 제공되는 정보 |
| --------- | ------------------------------------------------------------------------------------------------------------------------------------------------- |
| `session` | `session_id`, `agent_id`, `environment`, `started_at`, `ended_at`, `event_count`, `events`, 그리고 `count(event_type)`, `events_of_type(event_type)` |
| 각 이벤트 | `id`, `ts`, `event_type`, `payload` |
| 결과 유형 | `EvalResult`, `Score`, `Metric`, `Assertion`, 그리고 조건용 `ConditionResult` |
| 내장 함수 | `abs`, `all`, `any`, `bool`, `dict`, `float`, `int`, `len`, `list`, `max`, `min`, `range`, `round`, `set`, `sorted`, `str`, `sum`, `tuple` |
이외에는 접근할 수 없습니다. import도 불가하며, 세션 데이터와 `get`, `lower`, `split` 같은 기본 문자열 및 딕셔너리 메서드 외의 속성은 사용할 수 없습니다. 이 메서드들은 참조가 아닌 호출 방식으로 사용해야 합니다. 페이로드 키는 에이전트가 전송하는 내용에 따라 달라집니다. 위의 `status`는 예시일 뿐이므로, 실제 세션에서 키를 직접 확인하세요. **format**은 코드를 정리하고, **fix**는 어시스턴트에게 수정을 요청합니다. 코드는 최대 128 KiB, 조건은 최대 16 KiB까지 작성할 수 있습니다.
 ## 사용자 자신의 워커에서 작성하기
평가에 모델, 패키지, 시크릿, 또는 네트워크가 필요한 경우, [Evaluator SDK](/ko/reference/evaluator-sdk)를 사용하여 작성하고 자체 인프라에서 실행하세요. 동일한 결과 유형을 사용하며, 결과는 호스팅된 결과 옆에 **customer** 태그와 함께 표시됩니다:
```python theme={null}
@app.eval("answer_relevance", version="judge-v1", labels=["llm_judge"], timeout_seconds=30)
async def answer_relevance(session):
value, reasoning = await ask_judge(session) # your LLM call: a 0-1 score and why
return EvalResult(score=Score(value, passed=value >= 0.7), reasoning=reasoning)
```