> ## Documentation Index
> Fetch the complete documentation index at: https://docs.befailproof.ai/llms.txt
> Use this file to discover all available pages before exploring further.
# Escrever uma avaliação
> Descreva o que medir e deixe o assistente criar uma avaliação Python hospedada, ou escreva o código você mesmo. Juízes LLM rodam no seu próprio worker.
Avaliações hospedadas são pequenos scripts Python determinísticos, escritos no dashboard e executados na frota de avaliadores da Failproof AI. Lógicas mais pesadas — um juiz LLM, um pacote, um segredo, uma chamada de rede — rodam no [seu próprio worker](#escrever-no-seu-próprio-worker).
## Criar a partir de uma descrição
1. Acesse **Analyze → eval authoring** e selecione **new eval**.
2. Descreva o que medir em linguagem natural, ou escolha em **start from an example…**, e selecione **draft**.
3. Revise os campos e o código gerado, depois [teste](/pt-br/evaluations/test) e [publique](/pt-br/evaluations/deploy).
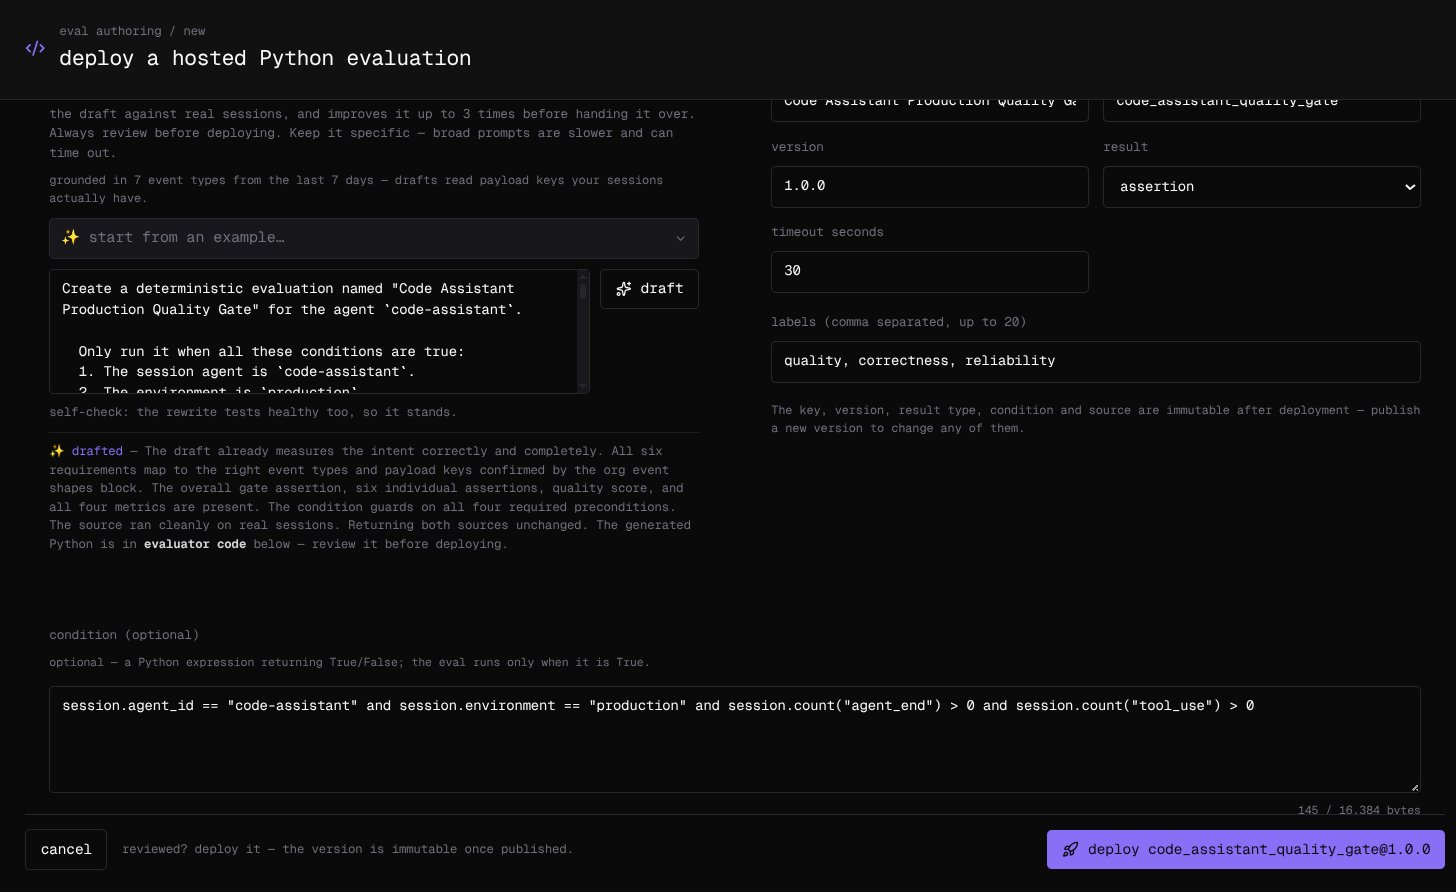 O rascunho é baseado nos eventos da sua própria organização: a página lê quais chaves de payload suas sessões carregaram nos últimos sete dias, de modo que o código use chaves reais em vez de suposições. Antes de entregar o rascunho, o assistente o testa em até cinco das suas sessões recentes, corrige tudo o que conseguir provar estar errado — em até três rodadas — e verifica se o código mede o que você pediu. Seja específico na descrição: prompts amplos são mais lentos e podem ultrapassar o tempo limite. De qualquer forma, revise o código; a publicação nunca é bloqueada.
## Configurar os campos
| Campo | O que é |
| --------------- | -------------------------------------------------------------------------------------------------- |
| name | O que as pessoas veem. Editável depois |
| key | O identificador estável sob o qual os resultados são agrupados, como `code_assistant_quality_gate` |
| version | Qualquer string de versão sem espaços, como `1.0.0` |
| result | **score** (0 a 1), **metric** (um número com unidade) ou **assertion** (passou ou não) |
| timeout seconds | Padrão 30. O sandbox interrompe qualquer execução individual em 60 |
| labels | Até 20, separadas por vírgula. Editável depois |
| condition | Opcional. Uma expressão Python; a avaliação só roda em sessões onde o valor for `True` |
Use a condição para restringir uma avaliação aos agentes e ambientes para os quais ela foi criada:
```python theme={null}
session.agent_id == "code-assistant" and session.environment == "production"
```
A chave, versão, tipo de resultado, condição e código são imutáveis após a publicação: para alterar qualquer um deles, publique uma nova versão. O nome, as labels e se está habilitada permanecem editáveis.
## Escrever o código você mesmo
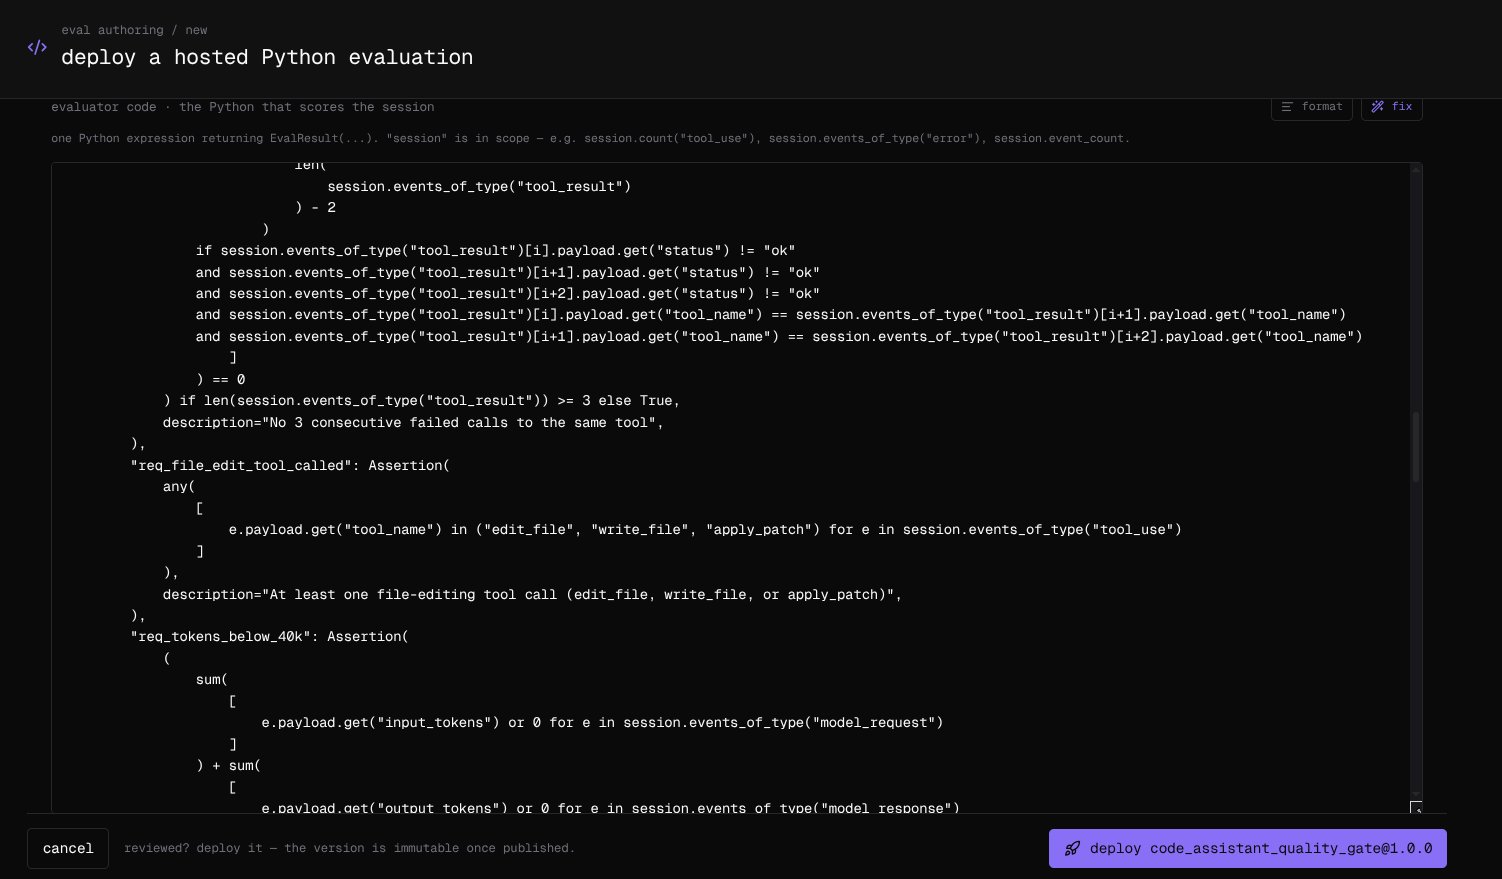
O **evaluator code** é uma única expressão Python que retorna `EvalResult(...)`, com `session` disponível no escopo. Este exemplo calcula a proporção de resultados de ferramentas que retornaram ok:
```python theme={null}
EvalResult(
score=Score(
len([e for e in session.events_of_type("tool_result") if e.payload.get("status") == "ok"])
/ max(1, session.count("tool_result"))
),
metrics={"tool_calls": Metric(session.count("tool_use"), unit="calls")},
reasoning="Share of tool results that came back ok.",
)
```
Um resultado começa com a chave da própria avaliação, no tipo declarado: `score=` para uma avaliação de pontuação, ou uma entrada em `metrics` ou `assertions` com o nome da chave para uma avaliação de métrica ou asserção. Outras métricas e asserções podem acompanhá-la, com até 25 resultados por execução.
| No escopo | Disponibiliza |
| ------------------ | ------------------------------------------------------------------------------------------------------------------------------------------------------- |
| `session` | `session_id`, `agent_id`, `environment`, `started_at`, `ended_at`, `event_count` e `events`, além de `count(event_type)` e `events_of_type(event_type)` |
| Cada evento | `id`, `ts`, `event_type` e `payload` |
| Tipos de resultado | `EvalResult`, `Score`, `Metric`, `Assertion` e `ConditionResult` para uma condição |
| Builtins | `abs`, `all`, `any`, `bool`, `dict`, `float`, `int`, `len`, `list`, `max`, `min`, `range`, `round`, `set`, `sorted`, `str`, `sum`, `tuple` |
Nada mais está acessível: sem imports, e sem atributos além dos dados de sessão e métodos simples de string e dicionário como `get`, `lower` e `split`, que devem ser chamados e não apenas referenciados. As chaves de payload são o que seus agentes enviam — `status` acima é apenas um exemplo — portanto, leia-as de uma sessão real. **format** organiza o código e **fix** pede ao assistente que o corrija. O código pode ter até 128 KiB, e a condição até 16 KiB.
 ## Escrever no seu próprio worker
Quando uma avaliação precisa de um modelo, um pacote, um segredo ou acesso à rede, escreva-a com o [Evaluator SDK](/pt-br/reference/evaluator-sdk) e execute-a na sua própria infraestrutura. Ela usa os mesmos tipos de resultado, e seus resultados aparecem ao lado dos hospedados, marcados como **customer**:
```python theme={null}
@app.eval("answer_relevance", version="judge-v1", labels=["llm_judge"], timeout_seconds=30)
async def answer_relevance(session):
value, reasoning = await ask_judge(session) # sua chamada LLM: uma pontuação de 0-1 e o motivo
return EvalResult(score=Score(value, passed=value >= 0.7), reasoning=reasoning)
```