> ## Documentation Index
> Fetch the complete documentation index at: https://docs.befailproof.ai/llms.txt
> Use this file to discover all available pages before exploring further.
# Написать оценку
> Опишите, что нужно измерить, и позвольте помощнику составить размещённую оценку на Python, или напишите код сами. Судьи на основе LLM работают в вашем воркере.
Размещённые оценки — это небольшие детерминированные программы на Python, написанные в панели управления и выполняемые на оценочном кластере Failproof AI. Более сложную логику — судью на основе LLM, пакет, секрет, сетевой запрос — лучше запустить в [вашем собственном воркере](#написать-в-своём-воркере).
## Составить оценку из описания
1. Перейдите в **Analyze → eval authoring** и выберите **new eval**.
2. Опишите, что нужно измерить, на простом английском языке или выберите **start from an example…**, затем нажмите **draft**.
3. Проверьте поля и сгенерированный код, потом [протестируйте его](/ru/evaluations/test) и [разверните](/ru/evaluations/deploy).
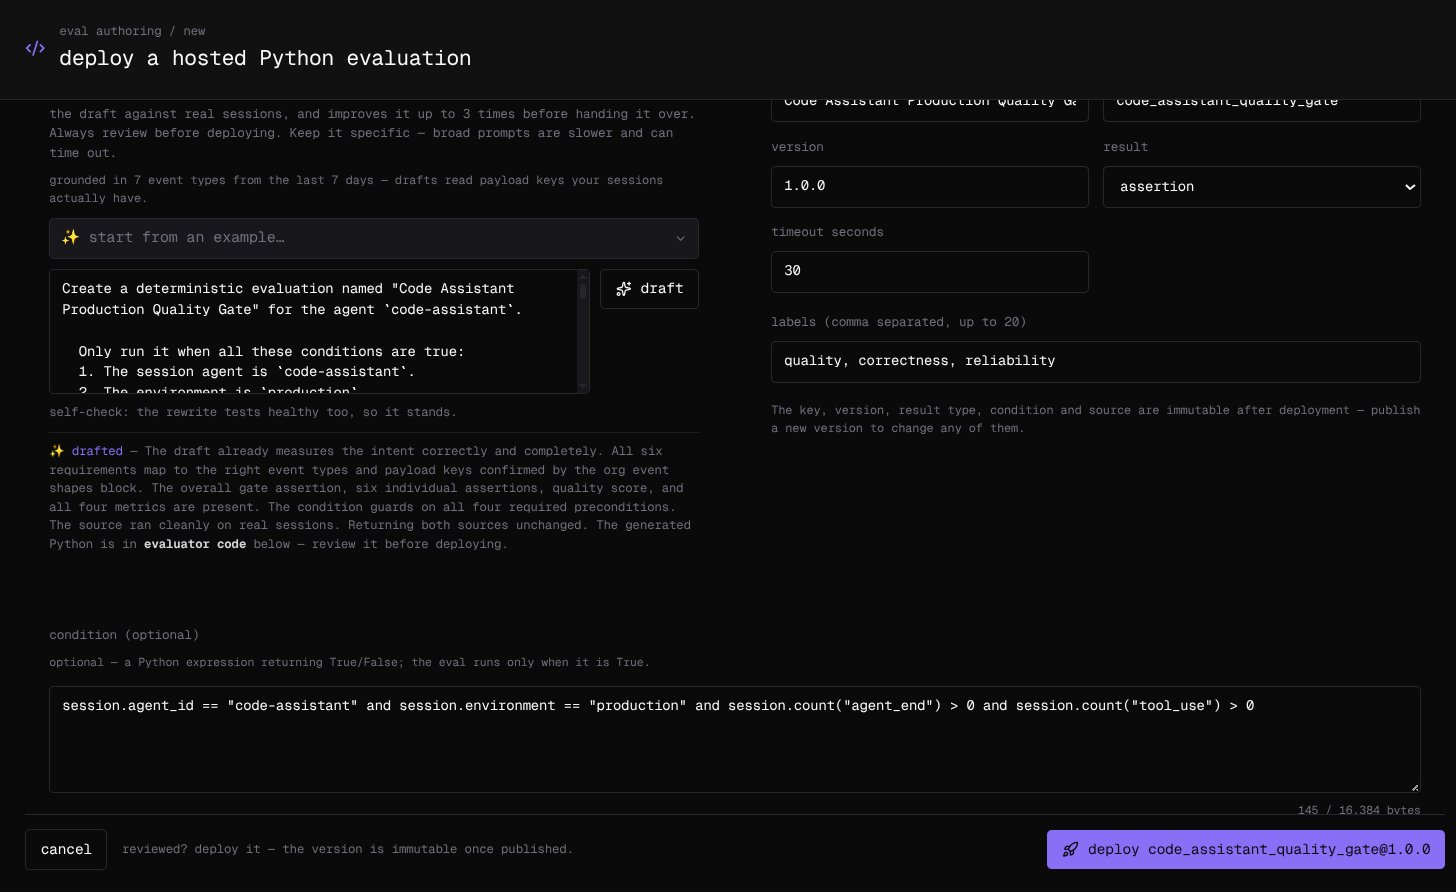 Черновик основан на событиях вашей организации: страница определяет, какие ключи полезной нагрузки были в ваших сессиях за последние семь дней, поэтому код читает существующие ключи, а не угадывает. Перед тем как предложить черновик, помощник тестирует его на до пяти недавних сессий, исправляет всё, что он может доказать, что сломано — до трёх раундов — и один раз проверяет, что код измеряет именно то, что вы просили. Делайте описание конкретным: широкие запросы медленнее и могут истечь по времени. Всё равно проверьте код; развёртывание никогда не блокируется.
## Установить поля
| Поле | Что это |
| --------------- | --------------------------------------------------------------------------------------------------------- |
| name | То, что видят люди. Можно редактировать позже |
| key | Стабильный идентификатор, под которым группируются его результаты, например `code_assistant_quality_gate` |
| version | Любая строка версии без пробелов, например `1.0.0` |
| result | **score** (от 0 до 1), **metric** (число с единицей) или **assertion** (пройдено или нет) |
| timeout seconds | По умолчанию 30. Изолированная среда останавливает любой отдельный запуск на 60 |
| labels | До 20, разделённые запятыми. Можно редактировать позже |
| condition | Необязательно. Выражение на Python; оценка запускается только на сессиях, где оно имеет значение `True` |
Используйте условие, чтобы ограничить оценку агентами и средами, для которых она предназначена:
```python theme={null}
session.agent_id == "code-assistant" and session.environment == "production"
```
Ключ, версия, тип результата, условие и код неизменяемы после развёртывания: чтобы изменить любое из них, опубликуйте новую версию. Имя, метки и статус включения остаются редактируемыми.
## Написать код самостоятельно
**Код оценки** — это одно выражение на Python, которое возвращает `EvalResult(...)` с доступным `session`. Вот пример, который оценивает долю результатов инструмента, которые пришли в порядке:
```python theme={null}
EvalResult(
score=Score(
len([e for e in session.events_of_type("tool_result") if e.payload.get("status") == "ok"])
/ max(1, session.count("tool_result"))
),
metrics={"tool_calls": Metric(session.count("tool_use"), unit="calls")},
reasoning="Share of tool results that came back ok.",
)
```
Результат начинается с собственного ключа оценки в объявленном типе: `score=` для оценки-балла или запись `metrics` или `assertions` с именем ключа для метрики или утверждения. Другие метрики и утверждения идут с ним, до 25 результатов в запуске.
| В области видимости | Предоставляет |
| ------------------- | ---------------------------------------------------------------------------------------------------------------------------------------------------- |
| `session` | `session_id`, `agent_id`, `environment`, `started_at`, `ended_at`, `event_count` и `events`, плюс `count(event_type)` и `events_of_type(event_type)` |
| Каждое событие | `id`, `ts`, `event_type` и `payload` |
| Типы результатов | `EvalResult`, `Score`, `Metric`, `Assertion` и `ConditionResult` для условия |
| Встроенные функции | `abs`, `all`, `any`, `bool`, `dict`, `float`, `int`, `len`, `list`, `max`, `min`, `range`, `round`, `set`, `sorted`, `str`, `sum`, `tuple` |
Больше ничего недоступно: нет импортов и нет атрибутов кроме данных сессии и простых методов строк и словарей, таких как `get`, `lower` и `split`, которые должны вызываться, а не просто ссылаться. Ключи полезной нагрузки — это всё, что отправляют ваши агенты — `status` выше только пример — поэтому берите их из реальной сессии. **format** приводит код в порядок, а **fix** просит помощника его исправить. Код может быть до 128 КиБ, условие — до 16 КиБ.
 ## Написать в своём воркере
Когда оценке требуется модель, пакет, секрет или сеть, напишите её с помощью [Evaluator SDK](/ru/reference/evaluator-sdk) и запустите в собственной инфраструктуре. Она использует те же типы результатов, и её результаты появляются рядом с размещёнными, помеченные **customer**:
```python theme={null}
@app.eval("answer_relevance", version="judge-v1", labels=["llm_judge"], timeout_seconds=30)
async def answer_relevance(session):
value, reasoning = await ask_judge(session) # your LLM call: a 0-1 score and why
return EvalResult(score=Score(value, passed=value >= 0.7), reasoning=reasoning)
```