> ## Documentation Index
> Fetch the complete documentation index at: https://docs.befailproof.ai/llms.txt
> Use this file to discover all available pages before exploring further.
# Bir değerlendirme yazın
> Neyi ölçeceğinizi açıklayın ve asistanın barındırılan bir Python değerlendirmesini taslak hale getirmesini sağlayın veya kodu kendiniz yazın. LLM hakimleri kendi worker'ınızda çalışır.
Barındırılan değerlendirmeler, panoda yazılan ve Failproof AI'nin değerlendirici filosunda çalıştırılan küçük, belirleyici Python kodlarıdır. Daha ağır mantık — bir LLM hakim, bir paket, bir gizli anahtar, bir ağ çağrısı — bunun yerine [kendi worker'ınızda](#bunu-kendi-worker-ınızda-yazın) çalışır.
## Bir açıklamadan taslak oluşturun
1. **Analyze → eval authoring** öğesine gidin ve **new eval** öğesini seçin.
2. Ölçülecek şeyi düz İngilizce'de açıklayın veya **start from an example…** öğesinden seçim yapın ve **draft** öğesini seçin.
3. Alanları ve doldurduğu kodu gözden geçirin, ardından [test edin](/tr/evaluations/test) ve [dağıtın](/tr/evaluations/deploy).
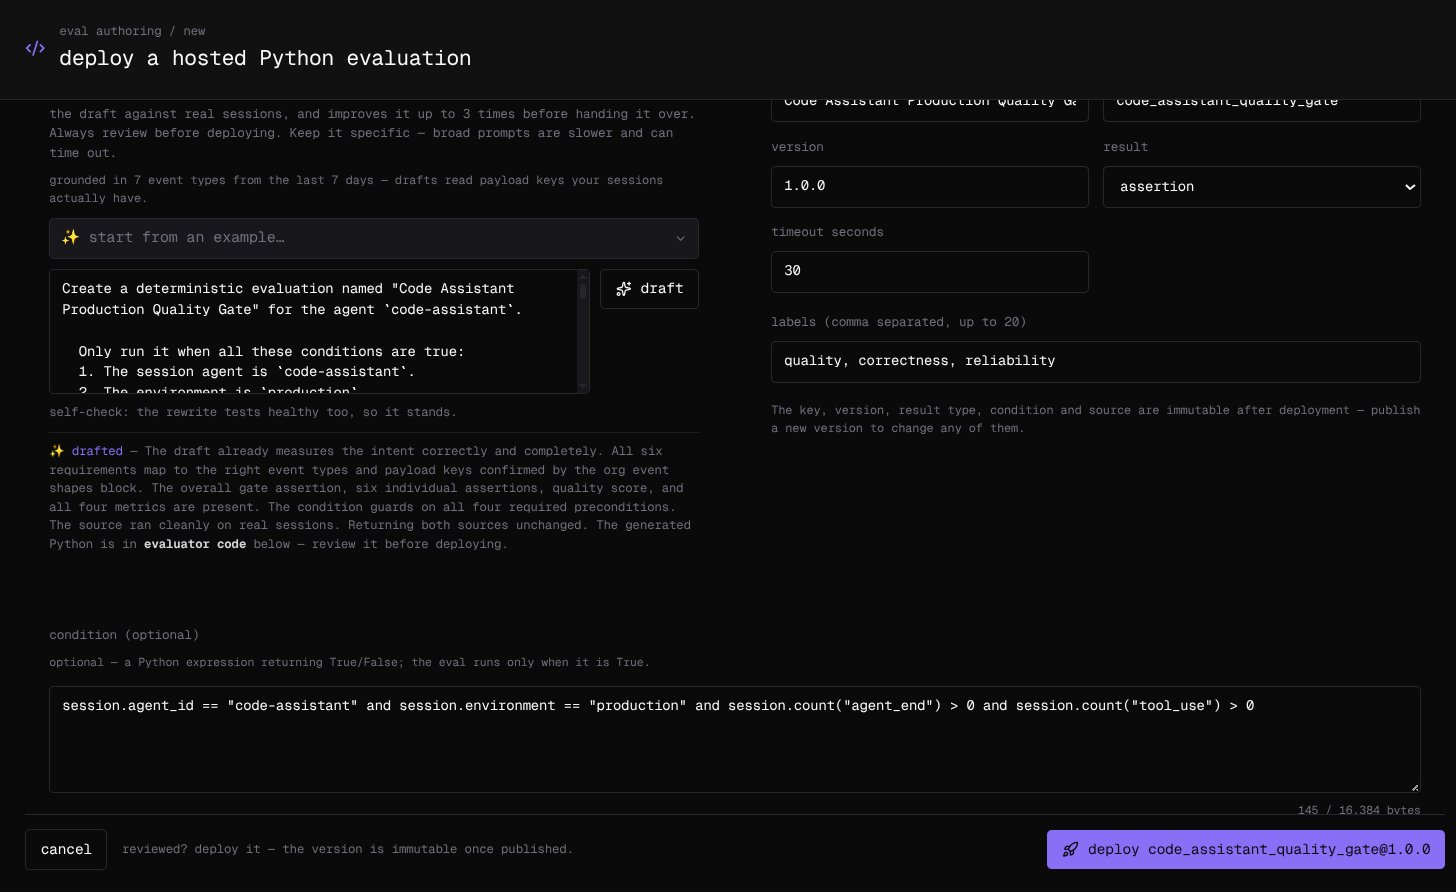 Taslak, kuruluşunuzun kendi etkinliklerine dayanır: sayfa, oturumlarınızın son yedi gün içinde hangi yük anahtarlarını taşıdığını okur, böylece kod tahmin etmek yerine var olan anahtarları okur. Taslağı teslim etmeden önce, asistan onu son oturumlarınızdan beşe kadarına karşı test eder, kanıtlayabileceği herhangi bir şeyi onarır — üç tura kadar — ve kodu istediğiniz şeyi ölçüp ölçmediğini bir kez daha kontrol eder. Açıklamayı spesifik tutun: geniş istekler daha yavaş olabilir ve zaman aşımına uğrayabilir. Her halükarda kodu gözden geçirin; dağıtım asla engellenmez.
## Alanları ayarlayın
| Alan | Nedir |
| --------------- | --------------------------------------------------------------------------------------------------------- |
| name | İnsanların gördüğü şey. Daha sonra düzenlenebilir |
| key | Sonuçlarını grafiklere çizen kararlı tanımlayıcı, örneğin `code_assistant_quality_gate` |
| version | Boşluk olmayan herhangi bir sürüm dizesi, örneğin `1.0.0` |
| result | **score** (0 ile 1 arasında), **metric** (bir birime sahip sayı) veya **assertion** (geçti ya da geçmedi) |
| timeout seconds | Varsayılan 30. Sandbox herhangi bir çalışmayı 60'ta durdurur |
| labels | En fazla 20, virgülle ayrılmış. Daha sonra düzenlenebilir |
| condition | İsteğe bağlı. Bir Python ifadesi; değerlendirme yalnızca `True` olduğu oturumlarla çalışır |
Bir değerlendirmeyi bunu amaçlayan aracılara ve ortamlara kapsamı belirlemek için koşulu kullanın:
```python theme={null}
session.agent_id == "code-assistant" and session.environment == "production"
```
Anahtar, sürüm, sonuç türü, koşul ve kod dağıtıldıktan sonra değişmezdir: bunlardan herhangi birini değiştirmek için yeni bir sürüm yayınlayın. Ad, etiketler ve etkinleştirilip etkinleştirilmediği düzenlenebilir kalır.
## Kodu kendiniz yazın
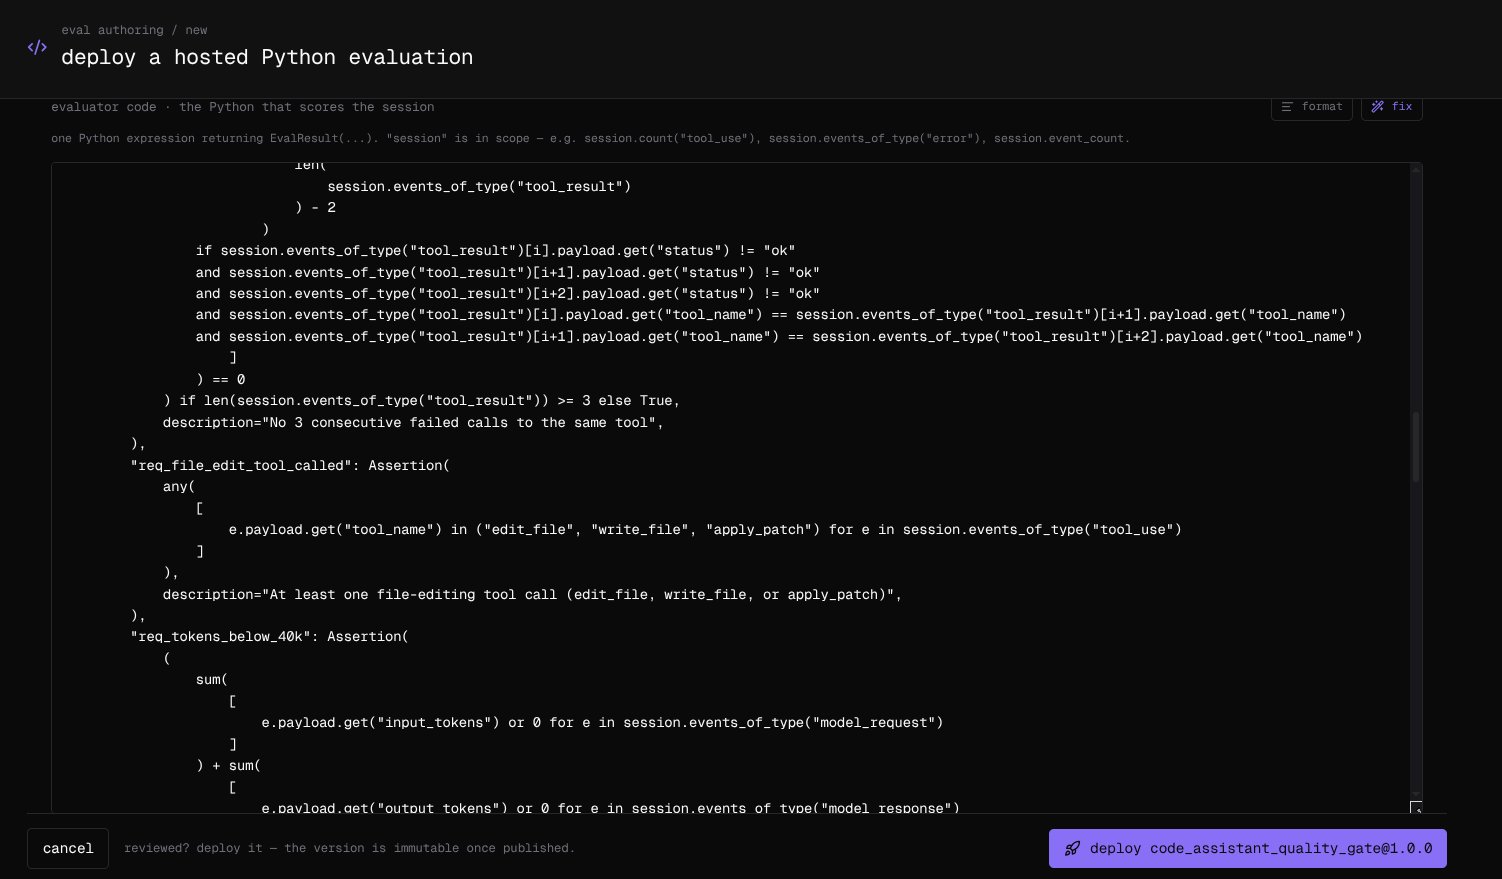
**Evaluator kodu**, `EvalResult(...)` döndüren tek bir Python ifadesidir ve `session` kapsamındadır. Bu, araç sonuçlarının iyi olma oranını puanlar:
```python theme={null}
EvalResult(
score=Score(
len([e for e in session.events_of_type("tool_result") if e.payload.get("status") == "ok"])
/ max(1, session.count("tool_result"))
),
metrics={"tool_calls": Metric(session.count("tool_use"), unit="calls")},
reasoning="Share of tool results that came back ok.",
)
```
Bir sonuç değerlendirmenin kendi anahtarı ile başlar, deklaresi edilen türünde: bir skor değerlendirmesi için `score=` veya bir metrik veya assertion değerlendirmesi için anahtarla adlandırılan `metrics` veya `assertions` girişi. Diğer metrikler ve iddialar bununla birlikte gider, bir çalışmada 25'e kadar sonuç.
| Kapsamında | Sağlar |
| ------------- | ------------------------------------------------------------------------------------------------------------------------------------------------------ |
| `session` | `session_id`, `agent_id`, `environment`, `started_at`, `ended_at`, `event_count` ve `events`, artı `count(event_type)` ve `events_of_type(event_type)` |
| Her olay | `id`, `ts`, `event_type` ve `payload` |
| Sonuç türleri | `EvalResult`, `Score`, `Metric`, `Assertion` ve bir koşul için `ConditionResult` |
| Builtins | `abs`, `all`, `any`, `bool`, `dict`, `float`, `int`, `len`, `list`, `max`, `min`, `range`, `round`, `set`, `sorted`, `str`, `sum`, `tuple` |
Başka hiçbir şeye ulaşılamaz: içe aktarma yok ve oturum verileri ve `get`, `lower` ve `split` gibi düz dize ve sözlük yöntemleri dışında hiçbir öznitelik yoktur ve bunlar başvurulan değil, çağrılan şeylerse. Yük anahtarları aracılarınızın gönderdiği şeydir — yukarıdaki `status` yalnızca bir örnektir — bunları gerçek bir oturumdan okuyun. **format** kodu temizler ve **fix** asistandan bunu onarmalarını ister. Kod 128 KiB'e kadar olabilir ve koşul 16 KiB'e kadar olabilir.
 ## Bunu kendi worker'ınızda yazın
Bir değerlendirme bir modele, bir pakete, bir gizli anahtara veya ağa ihtiyaç duyduğunda, onu [Evaluator SDK](/tr/reference/evaluator-sdk) ile yazın ve kendi altyapınızda çalıştırın. Aynı sonuç türlerini kullanır ve sonuçları barındırılan olanların yanında görünür, **customer** olarak etiketlenir:
```python theme={null}
@app.eval("answer_relevance", version="judge-v1", labels=["llm_judge"], timeout_seconds=30)
async def answer_relevance(session):
value, reasoning = await ask_judge(session) # your LLM call: a 0-1 score and why
return EvalResult(score=Score(value, passed=value >= 0.7), reasoning=reasoning)
```