> ## Documentation Index
> Fetch the complete documentation index at: https://docs.befailproof.ai/llms.txt
> Use this file to discover all available pages before exploring further.
# Viết một bài đánh giá
> Mô tả những gì cần đo lường và để trợ lý soạn thảo một bài đánh giá Python được lưu trữ, hoặc viết mã của riêng bạn. Các trọng tài LLM chạy trong worker của riêng bạn.
Các bài đánh giá được lưu trữ là những chương trình Python nhỏ và xác định, được viết trong bảng điều khiển và chạy trên đội đánh giá của Failproof AI. Logics nặng hơn — một trọng tài LLM, một gói, một bí mật, một lệnh gọi mạng — chạy trong [worker của riêng bạn](#viết-nó-trong-worker-của-riêng-bạn) thay thế.
## Soạn thảo từ một mô tả
1. Đi tới **Analyze → eval authoring** và chọn **new eval**.
2. Mô tả những gì cần đo lường bằng tiếng Anh thường nhật, hoặc chọn từ **start from an example…**, rồi chọn **draft**.
3. Xem xét các trường và mã nó điền vào, sau đó [kiểm tra nó](/vi/evaluations/test) và [triển khai nó](/vi/evaluations/deploy).
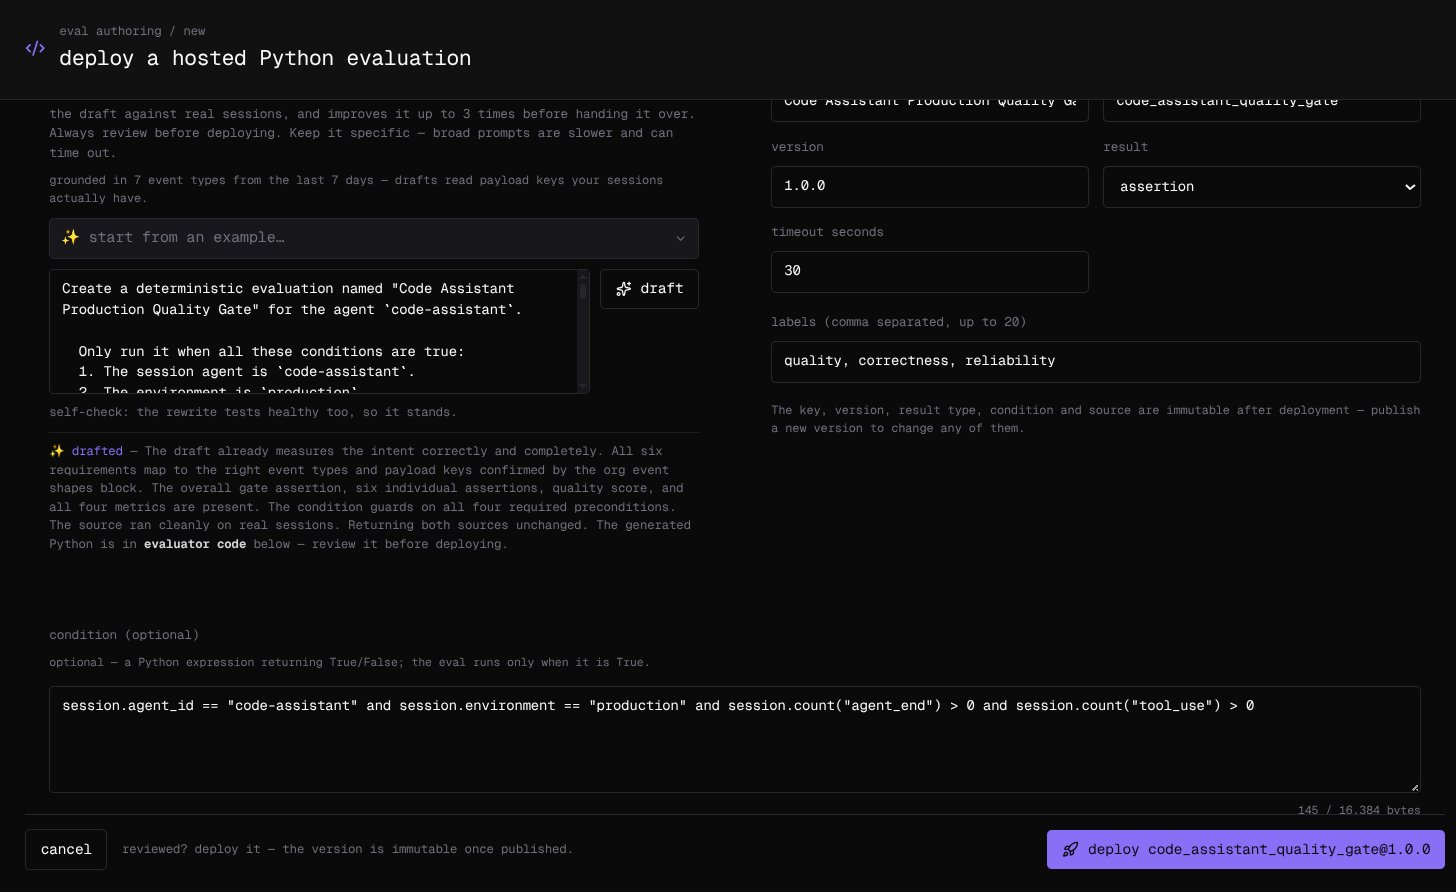 Bản soạn thảo được dựa trên các sự kiện của riêng tổ chức bạn: trang đọc những khóa tải trọng nào mà phiên của bạn đã sử dụng trong bảy ngày qua, vì vậy mã đọc các khóa tồn tại thay vì đoán. Trước khi chuyển bản soạn thảo, trợ lý kiểm tra nó dựa trên tối đa năm phiên gần đây của bạn, sửa chữa bất cứ điều gì nó có thể chứng minh là bị hỏng — trong tối đa ba vòng — và kiểm tra một lần rằng mã đo lường những gì bạn yêu cầu. Giữ mô tả cụ thể: các lời nhắc rộng nham rổn hơn và có thể hết thời gian chờ. Xem xét mã dù sao; triển khai không bao giờ bị chặn.
## Đặt các trường
| Trường | Nó là gì |
| --------------- | ---------------------------------------------------------------------------------------------- |
| name | Những gì mọi người nhìn thấy. Có thể chỉnh sửa sau |
| key | Định danh ổn định của nó kết quả sơ đồ dưới, chẳng hạn như `code_assistant_quality_gate` |
| version | Bất kỳ chuỗi phiên bản nào không có khoảng trắng, chẳng hạn như `1.0.0` |
| result | **score** (0 đến 1), **metric** (một số có một đơn vị), hoặc **assertion** (passed hoặc không) |
| timeout seconds | Mặc định 30. Hộp cát dừng bất kỳ lần chạy nào ở 60 |
| labels | Tối đa 20, cách nhau bằng dấu phẩy. Có thể chỉnh sửa sau |
| condition | Tùy chọn. Một biểu thức Python; bài đánh giá chỉ chạy trên các phiên mà nó là `True` |
Sử dụng điều kiện để phạm vi bài đánh giá đến các agent và môi trường nó được dùng cho:
```python theme={null}
session.agent_id == "code-assistant" and session.environment == "production"
```
Khóa, phiên bản, loại kết quả, điều kiện và mã là bất biến sau khi triển khai: để thay đổi bất kỳ trong số chúng, hãy xuất bản một phiên bản mới. Tên, nhãn và liệu nó được bật vẫn có thể chỉnh sửa.
## Viết mã của riêng bạn
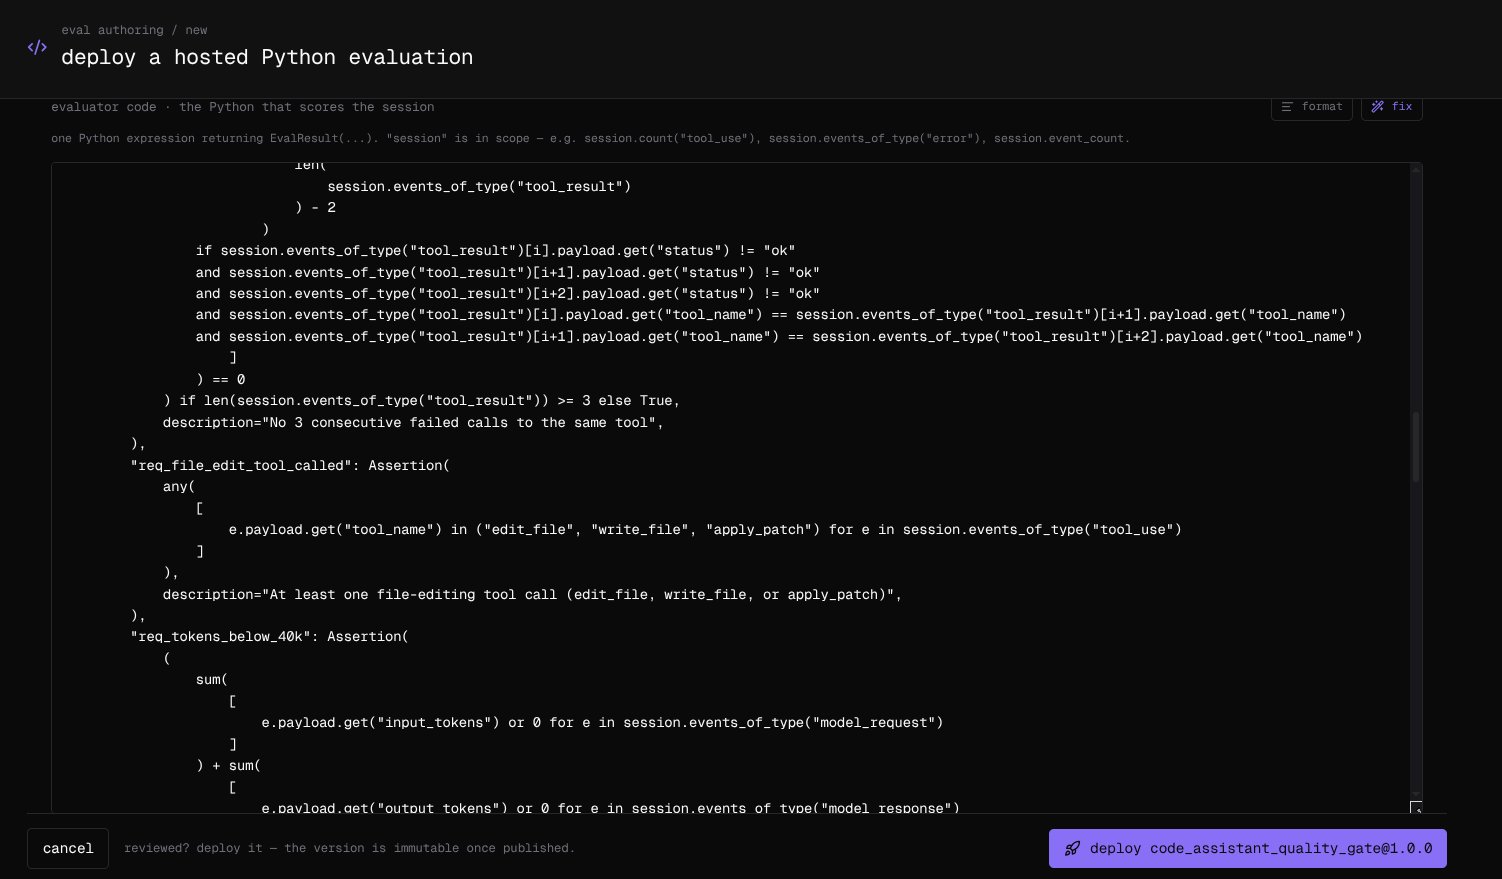
**evaluator code** là một biểu thức Python trả về `EvalResult(...)`, có `session` trong phạm vi. Cái này ghi điểm phần chia của kết quả công cụ quay trở lại ok:
```python theme={null}
EvalResult(
score=Score(
len([e for e in session.events_of_type("tool_result") if e.payload.get("status") == "ok"])
/ max(1, session.count("tool_result"))
),
metrics={"tool_calls": Metric(session.count("tool_use"), unit="calls")},
reasoning="Share of tool results that came back ok.",
)
```
Một kết quả dẫn đầu với khóa riêng của bài đánh giá, trong loại khai báo của nó: `score=` cho một bài đánh giá điểm, hoặc một `metrics` hoặc `assertions` mục được đặt tên theo khóa cho một số liệu hoặc một bài đánh giá khẳng định. Các số liệu và khẳng định khác đi cùng với nó, lên tới 25 kết quả trong một lần chạy.
| Trong phạm vi | Cung cấp cho bạn |
| ------------- | ----------------------------------------------------------------------------------------------------------------------------------------------------------- |
| `session` | `session_id`, `agent_id`, `environment`, `started_at`, `ended_at`, `event_count`, và `events`, cộng với `count(event_type)` và `events_of_type(event_type)` |
| Mỗi sự kiện | `id`, `ts`, `event_type`, và `payload` |
| Loại kết quả | `EvalResult`, `Score`, `Metric`, `Assertion`, và `ConditionResult` cho một điều kiện |
| Builtins | `abs`, `all`, `any`, `bool`, `dict`, `float`, `int`, `len`, `list`, `max`, `min`, `range`, `round`, `set`, `sorted`, `str`, `sum`, `tuple` |
Không gì khác là có thể tiếp cận: không nhập, và không có thuộc tính ngoài dữ liệu phiên đó và các phương thức chuỗi và từ điển thông thường chẳng hạn như `get`, `lower`, và `split`, chúng phải được gọi chứ không phải được tham chiếu. Khóa tải trọng là bất cứ thứ gì các agent của bạn gửi — `status` ở trên chỉ là một ví dụ — vì vậy hãy đọc chúng từ một phiên thực. **format** làm gọn mã và **fix** yêu cầu trợ lý sửa chữa nó. Mã có thể lên tới 128 KiB, và điều kiện lên tới 16 KiB.
 ## Viết nó trong worker của riêng bạn
Khi một bài đánh giá cần một mô hình, một gói, một bí mật, hoặc mạng, hãy viết nó với [Evaluator SDK](/vi/reference/evaluator-sdk) và chạy nó trên cơ sở hạ tầng của riêng bạn. Nó sử dụng các loại kết quả tương tự, và kết quả của nó xuất hiện bên cạnh những kết quả được lưu trữ, được gắn thẻ **customer**:
```python theme={null}
@app.eval("answer_relevance", version="judge-v1", labels=["llm_judge"], timeout_seconds=30)
async def answer_relevance(session):
value, reasoning = await ask_judge(session) # your LLM call: a 0-1 score and why
return EvalResult(score=Score(value, passed=value >= 0.7), reasoning=reasoning)
```