Các bài đánh giá được lưu trữ là những chương trình Python nhỏ và xác định, được viết trong bảng điều khiển và chạy trên đội đánh giá của Failproof AI. Logics nặng hơn — một trọng tài LLM, một gói, một bí mật, một lệnh gọi mạng — chạy trong worker của riêng bạn thay thế.

Soạn thảo từ một mô tả

  1. Đi tới Analyze → eval authoring và chọn new eval.
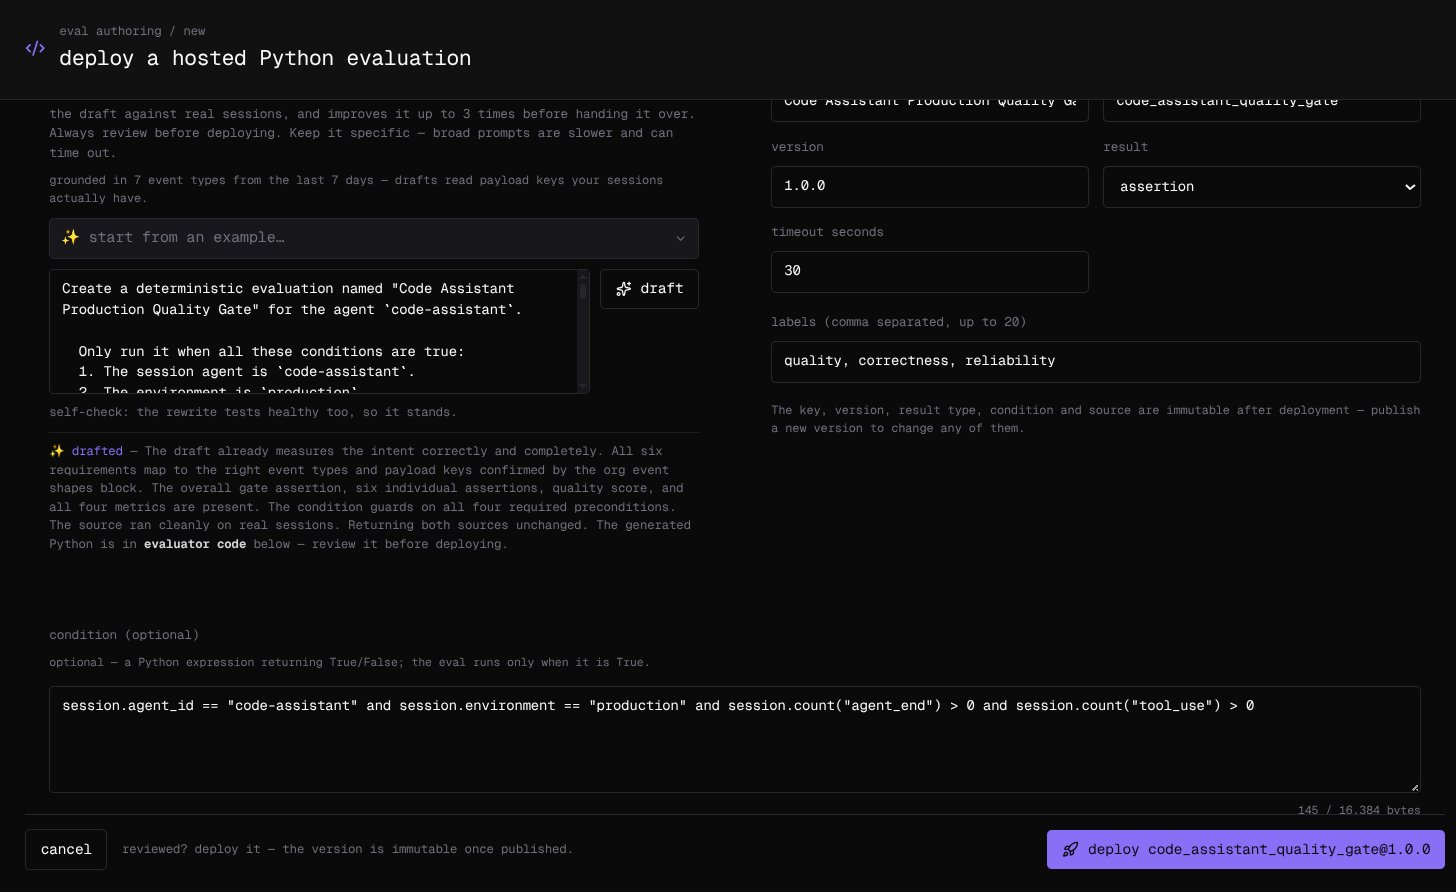
  2. Mô tả những gì cần đo lường bằng tiếng Anh thường nhật, hoặc chọn từ start from an example…, rồi chọn draft.
  3. Xem xét các trường và mã nó điền vào, sau đó kiểm tra nótriển khai nó.
Trang soạn thảo eval với một bài đánh giá được soạn thảo: mô tả, ghi chú của trợ lý về bản soạn thảo, và các trường tên, khóa, phiên bản, kết quả, thời gian chờ, nhãn và điều kiện. Bản soạn thảo được dựa trên các sự kiện của riêng tổ chức bạn: trang đọc những khóa tải trọng nào mà phiên của bạn đã sử dụng trong bảy ngày qua, vì vậy mã đọc các khóa tồn tại thay vì đoán. Trước khi chuyển bản soạn thảo, trợ lý kiểm tra nó dựa trên tối đa năm phiên gần đây của bạn, sửa chữa bất cứ điều gì nó có thể chứng minh là bị hỏng — trong tối đa ba vòng — và kiểm tra một lần rằng mã đo lường những gì bạn yêu cầu. Giữ mô tả cụ thể: các lời nhắc rộng nham rổn hơn và có thể hết thời gian chờ. Xem xét mã dù sao; triển khai không bao giờ bị chặn.

Đặt các trường

Sử dụng điều kiện để phạm vi bài đánh giá đến các agent và môi trường nó được dùng cho:
Khóa, phiên bản, loại kết quả, điều kiện và mã là bất biến sau khi triển khai: để thay đổi bất kỳ trong số chúng, hãy xuất bản một phiên bản mới. Tên, nhãn và liệu nó được bật vẫn có thể chỉnh sửa.

Viết mã của riêng bạn

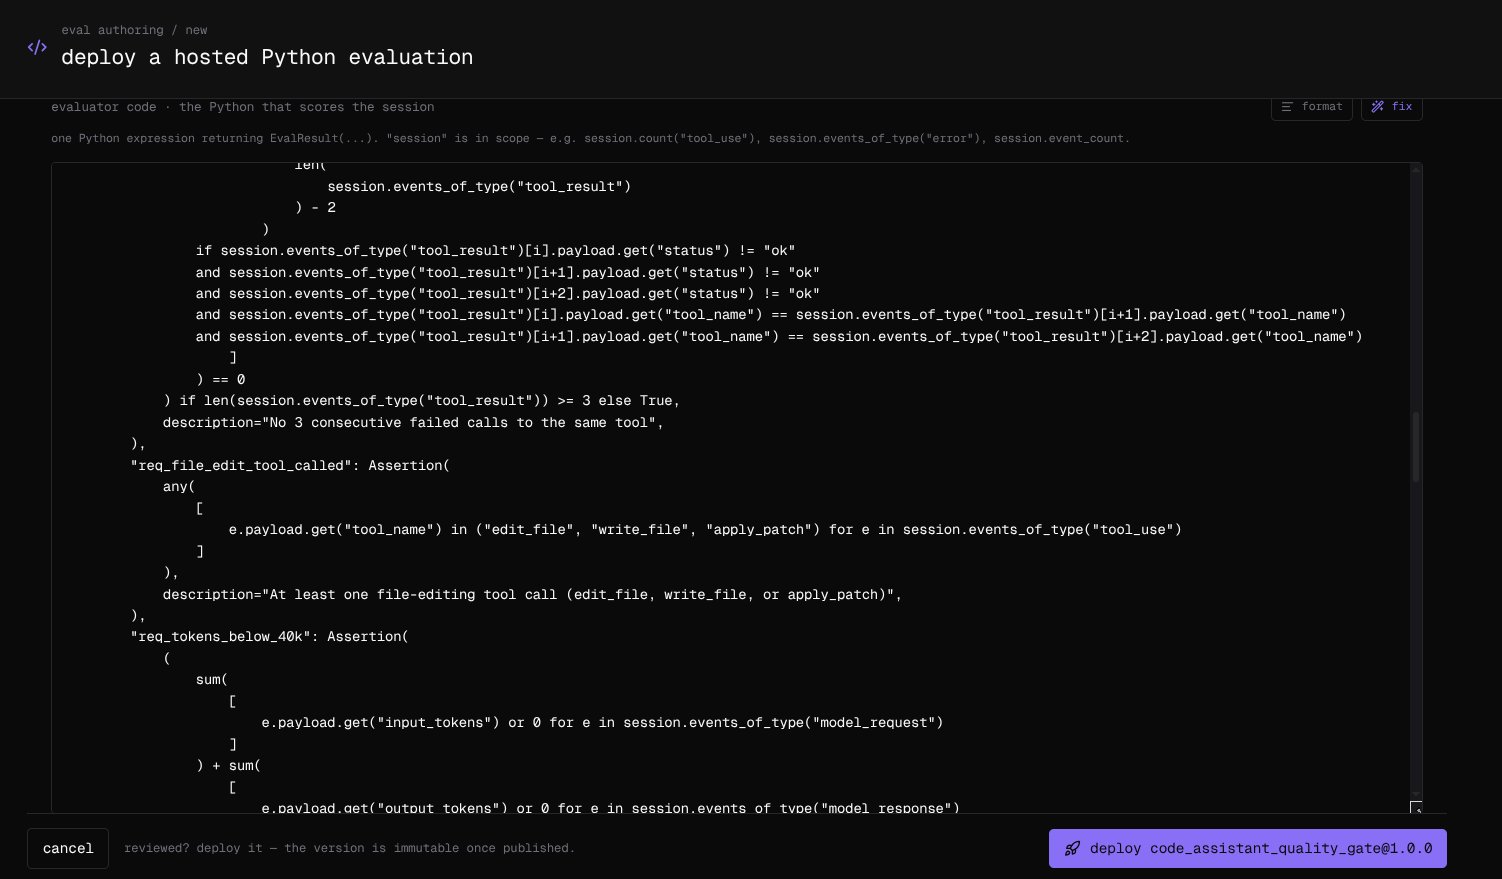
evaluator code là một biểu thức Python trả về EvalResult(...), có session trong phạm vi. Cái này ghi điểm phần chia của kết quả công cụ quay trở lại ok:
Một kết quả dẫn đầu với khóa riêng của bài đánh giá, trong loại khai báo của nó: score= cho một bài đánh giá điểm, hoặc một metrics hoặc assertions mục được đặt tên theo khóa cho một số liệu hoặc một bài đánh giá khẳng định. Các số liệu và khẳng định khác đi cùng với nó, lên tới 25 kết quả trong một lần chạy. Không gì khác là có thể tiếp cận: không nhập, và không có thuộc tính ngoài dữ liệu phiên đó và các phương thức chuỗi và từ điển thông thường chẳng hạn như get, lower, và split, chúng phải được gọi chứ không phải được tham chiếu. Khóa tải trọng là bất cứ thứ gì các agent của bạn gửi — status ở trên chỉ là một ví dụ — vì vậy hãy đọc chúng từ một phiên thực. format làm gọn mã và fix yêu cầu trợ lý sửa chữa nó. Mã có thể lên tới 128 KiB, và điều kiện lên tới 16 KiB. Trình chỉnh sửa mã đánh giá, với định dạng và sửa chữa, cho thấy các khẳng định của một bài đánh giá được soạn thảo.
Viết nó trong worker của riêng bạn

Khi một bài đánh giá cần một mô hình, một gói, một bí mật, hoặc mạng, hãy viết nó với Evaluator SDK và chạy nó trên cơ sở hạ tầng của riêng bạn. Nó sử dụng các loại kết quả tương tự, và kết quả của nó xuất hiện bên cạnh những kết quả được lưu trữ, được gắn thẻ customer: