托管评估是用 Python 编写的小型确定性程序,在仪表板中编写并在 Failproof AI 的评估器集群上运行。较复杂的逻辑——LLM 评判器、第三方包、密钥、网络调用——则在您自己的 worker 中运行。

从描述起草

  1. 前往 Analyze → eval authoring,选择 new eval
  2. 用自然语言描述要衡量的内容,或从 start from an example… 中选择,然后点击 draft
  3. 检查各字段和生成的代码,然后测试部署
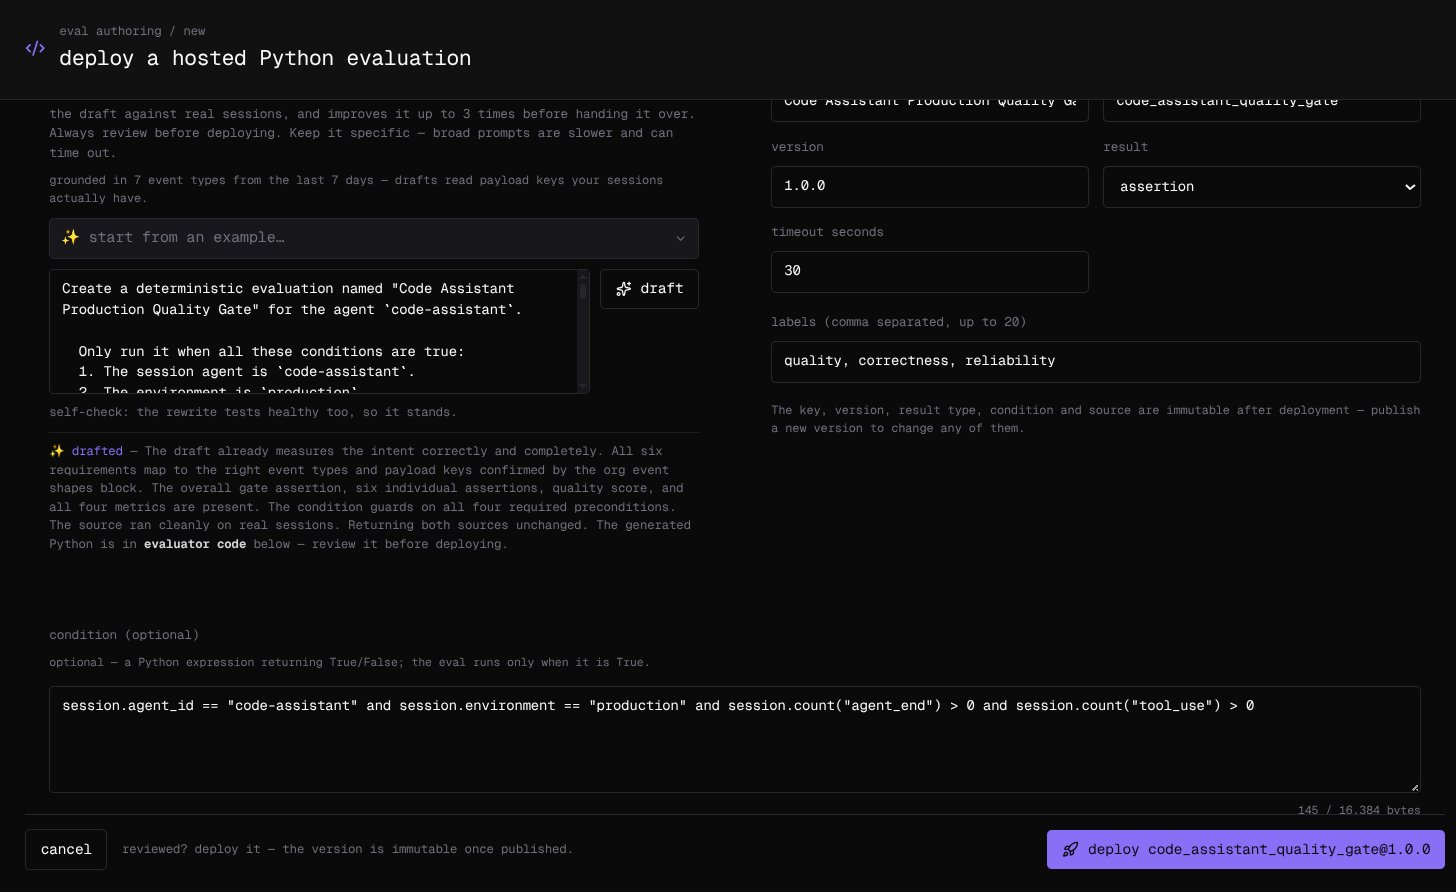
评估编写页面,显示已起草的评估:描述、助手对草稿的说明,以及名称、键、版本、结果、超时、标签和条件字段。 起草内容基于您组织自身的事件:页面会读取过去七天内会话携带的 payload 键,因此代码读取的是真实存在的键,而非猜测。在交付草稿之前,助手会针对您最近的最多五个会话进行测试,修复所有可以确认的问题(最多三轮),并再次确认代码是否衡量了您的要求。请尽量使描述具体:过于宽泛的提示会使处理变慢,甚至可能超时。无论如何都请审查代码;部署操作从不被阻止。

设置字段

使用 condition 将评估限定到目标 agent 和环境:
键、版本、结果类型、条件和代码在部署后不可修改:如需更改其中任何一项,请发布新版本。名称、标签及是否启用可随时编辑。

自己编写代码

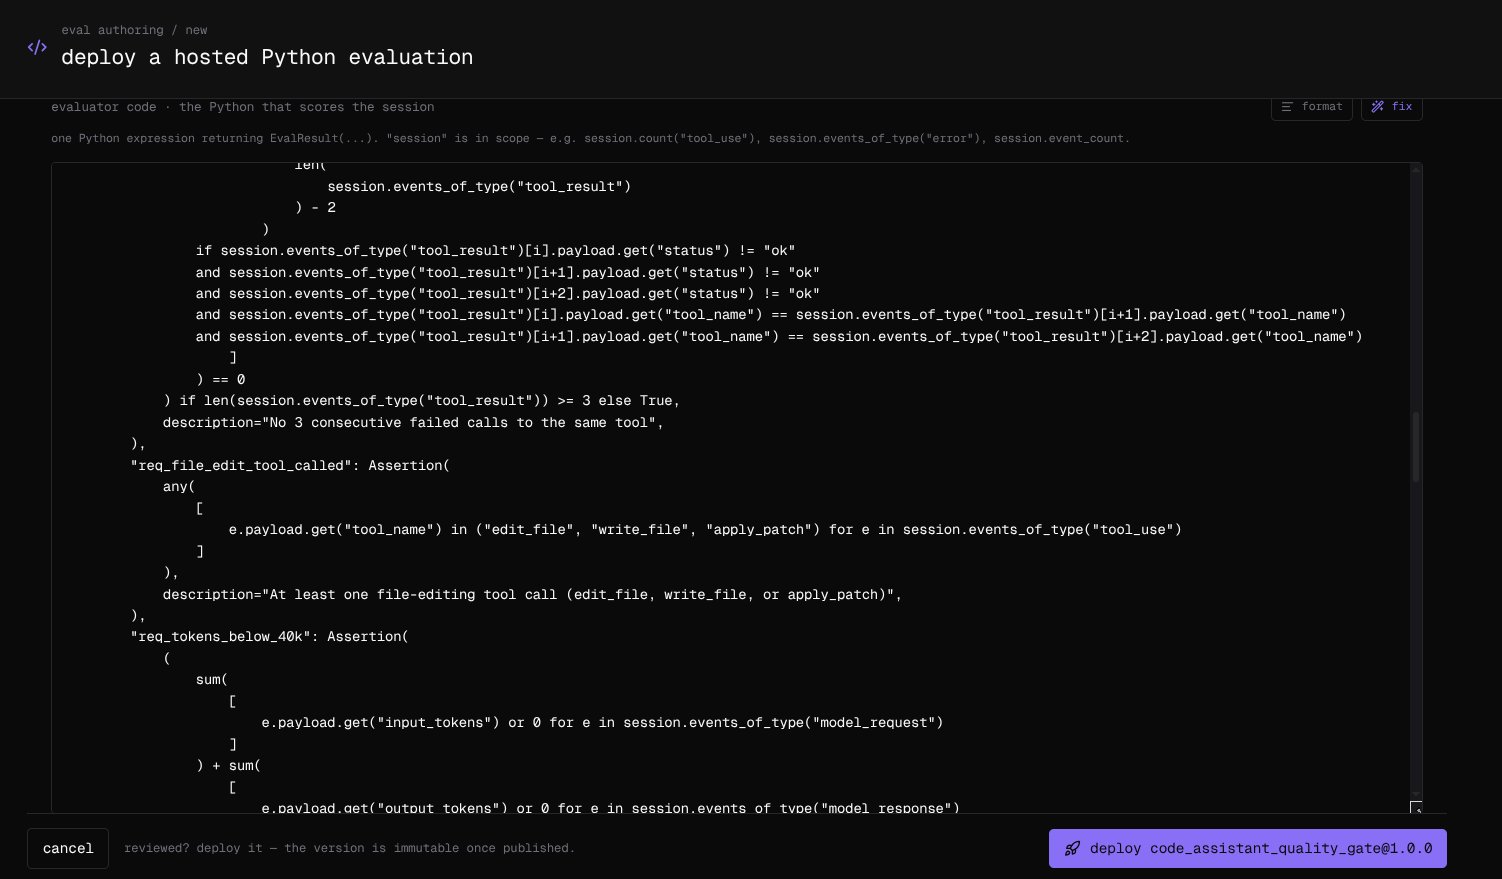
evaluator code 是一个返回 EvalResult(...) 的 Python 表达式,作用域内包含 session。以下示例对状态为 ok 的工具调用结果占比进行评分:
结果以评估本身的键为主,按其声明的类型:score 类评估用 score=,metric 或 assertion 类评估则在 metricsassertions 中使用以该键命名的条目。其他指标和断言可附带其中,每次运行最多 25 个结果。 除此之外均不可访问:不允许 import,也不能访问超出会话数据以及 getlowersplit 等普通字符串和字典方法的属性(这些方法必须被调用,而非仅引用)。Payload 键取决于您的 agent 发送的内容——上面的 status 仅为示例——因此请从真实会话中读取。format 可整理代码格式,fix 可让助手修复代码。代码最大 128 KiB,条件最大 16 KiB。 评估器代码编辑器,带有 format 和 fix 功能,显示已起草评估的断言内容。
在您自己的 worker 中编写

当评估需要模型、第三方包、密钥或网络时,请使用 Evaluator SDK 编写,并在您自己的基础设施上运行。它使用相同的结果类型,其结果会与托管评估一同显示,标记为 customer