होस्टेड मूल्यांकन छोटे, नियतात्मक Python होते हैं, जो डैशबोर्ड में लिखे जाते हैं और Failproof AI के evaluator fleet पर चलाए जाते हैं। भारी तर्क — एक LLM judge, एक पैकेज, एक secret, एक नेटवर्क कॉल — इसके बजाय आपके अपने worker में चलता है।

विवरण से मसौदा तैयार करें

  1. Analyze → eval authoring पर जाएं और new eval चुनें।
  2. सादी English में मापने के लिए क्या है यह बताएं, या start from an example… से चुनें, और draft को चुनें।
  3. Fields और code की समीक्षा करें, फिर इसे test करें और deploy करें
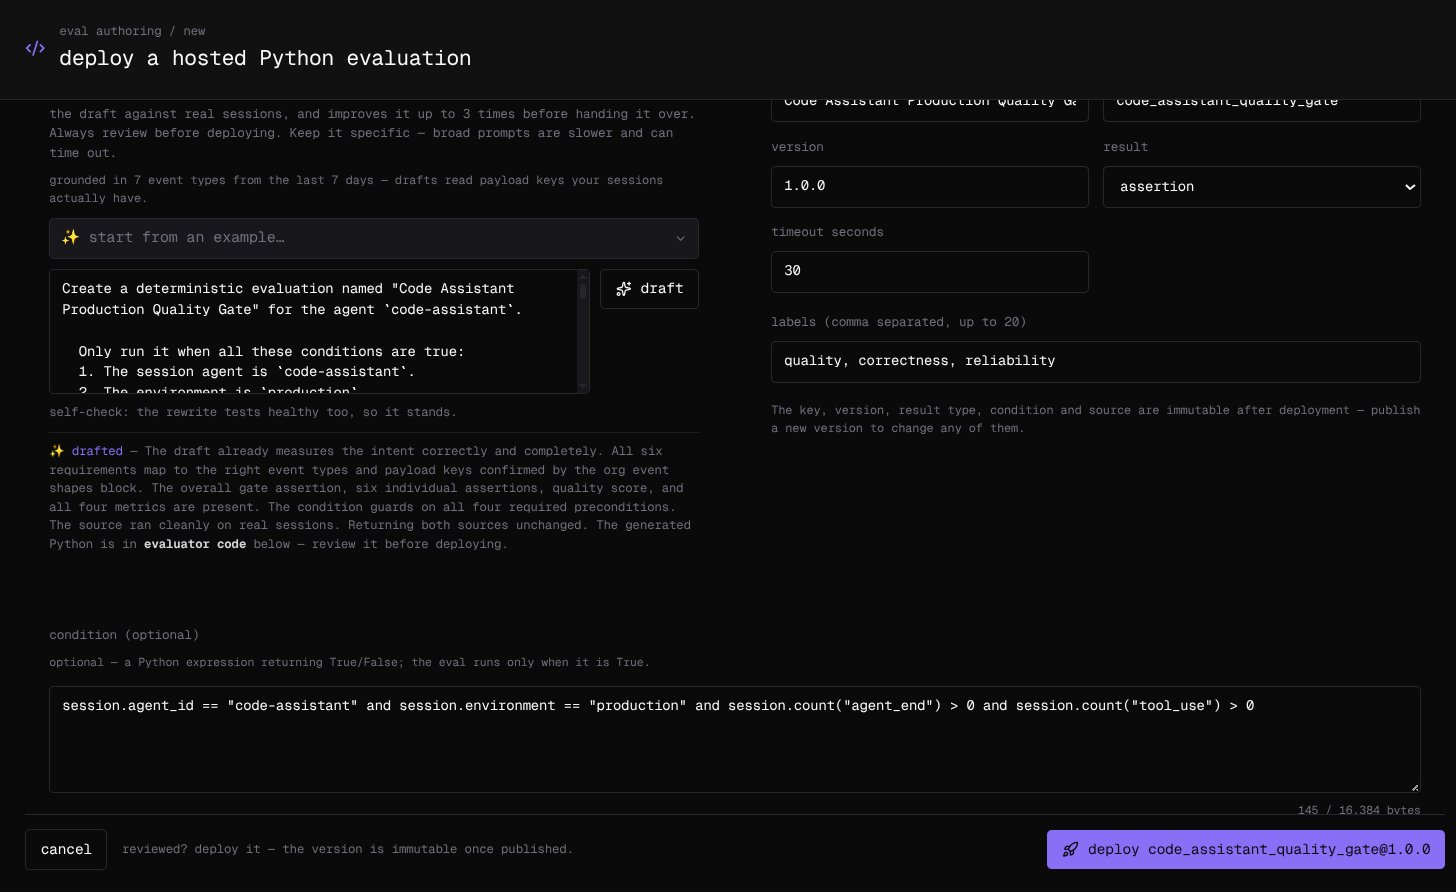
eval authoring पेज एक मसौदा मूल्यांकन के साथ: विवरण, मसौदे पर सहायक की नोट्स, और नाम, कुंजी, संस्करण, परिणाम, timeout, लेबल्स, और condition fields। मसौदा आपके संगठन की अपनी events पर आधारित है: पेज पढ़ता है कि आपके sessions ने पिछले सात दिनों में कौन सी payload keys ले जाई हैं, इसलिए code उन keys को पढ़ता है जो मौजूद हैं अनुमान लगाने के बजाय। मसौदे को सौंपने से पहले, सहायक इसे आपके हाल के पांच sessions के साथ परीक्षण करता है, कुछ भी ठीक करता है जो वह साबित कर सकता है कि टूटा हुआ है — तीन राउंड तक — और एक बार जांच करता है कि code आपने जो पूछा था वह मापता है। विवरण को विशिष्ट रखें: व्यापक prompts धीमे हो सकते हैं और timeout हो सकते हैं। किसी भी तरह से code की समीक्षा करें; deploying कभी भी blocked नहीं होता है।

Fields सेट करें

एक मूल्यांकन को उन agents और environments तक सीमित करने के लिए condition का उपयोग करें जिसके लिए यह meant है:
Key, version, result type, condition, और code deployment के बाद immutable हैं: इनमें से कोई भी बदलने के लिए, एक नया version publish करें। Name, labels, और क्या यह enabled है यह editable रहता है।

कोड स्वयं लिखें

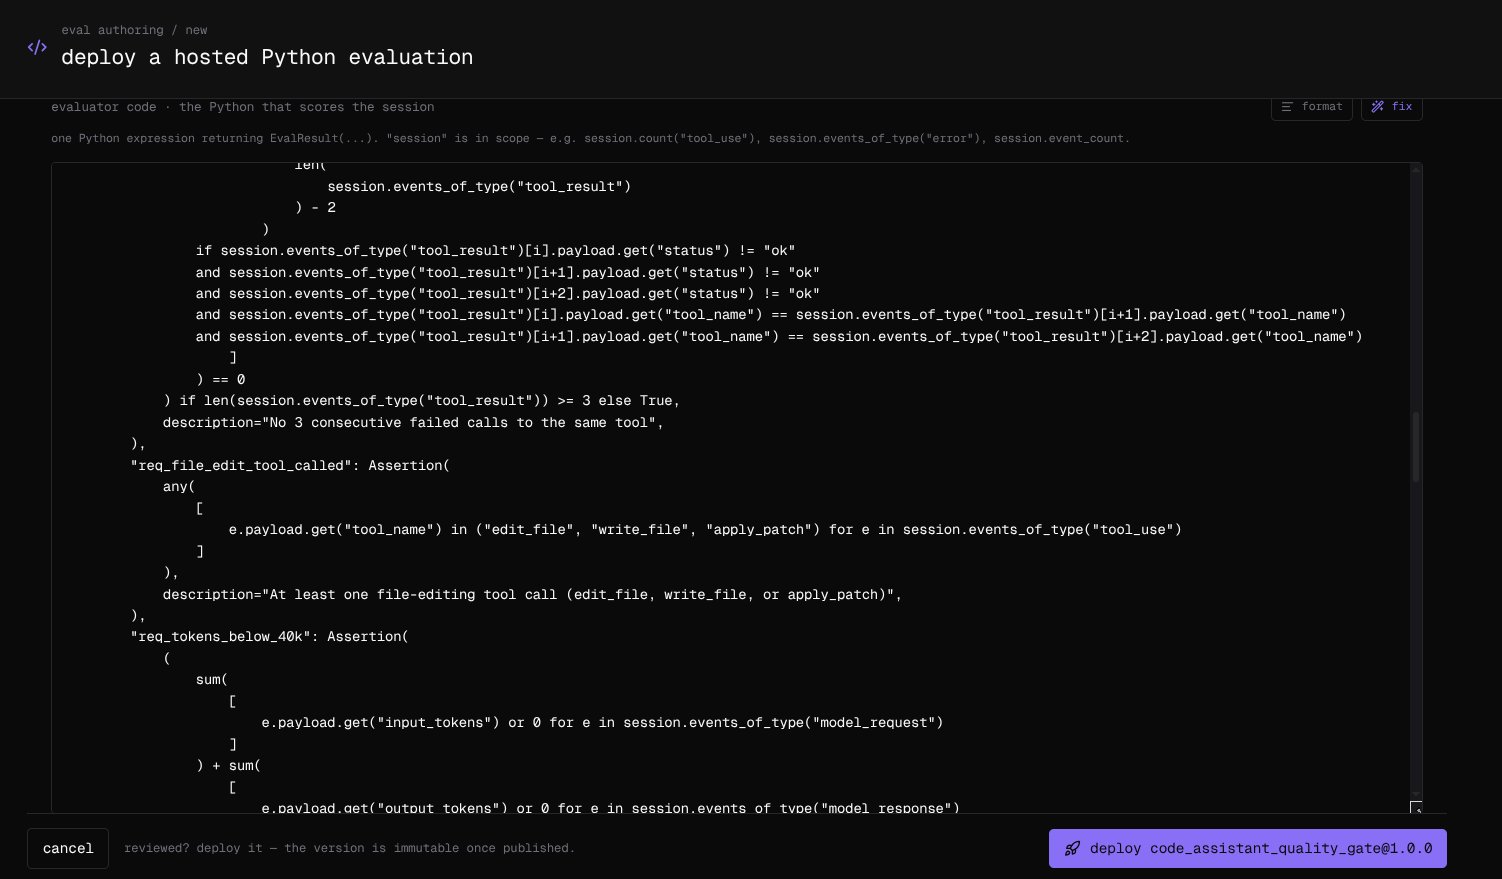
evaluator code एक Python expression है जो EvalResult(...) return करता है, जिसमें session in scope है। यह tool results के share को score करता है जो ok आए:
एक result मूल्यांकन की अपनी key के साथ शुरू होता है, अपने declared type में: score evaluation के लिए score=, या एक metric या assertion evaluation के लिए key के नाम से एक metrics या assertions entry। अन्य metrics और assertions इसके साथ ride करते हैं, एक run में 25 परिणाम तक। कुछ भी और reachable नहीं है: कोई imports नहीं, और session data और plain string और dictionary methods जैसे get, lower, और split से परे कोई attributes नहीं, जिन्हें reference किए जाने के बजाय called होना चाहिए। Payload keys वह हैं जो आपके agents भेजते हैं — status ऊपर केवल एक example है — इसलिए उन्हें एक real session से पढ़ें। format code को tidy करता है और fix सहायक को इसे repair करने के लिए कहता है। Code 128 KiB तक हो सकता है, और condition 16 KiB तक हो सकता है। evaluator code editor, format और fix के साथ, एक मसौदा मूल्यांकन की assertions दिखा रहा है।
इसे अपने worker में लिखें

जब एक मूल्यांकन को एक model, एक पैकेज, एक secret, या नेटवर्क की आवश्यकता होती है, तो इसे Evaluator SDK के साथ लिखें और इसे अपने infrastructure पर चलाएं। यह same result types का उपयोग करता है, और इसके परिणाम hosted ones के बगल में दिखाई देते हैं, customer tagged: