

Las evaluaciones alojadas son pequeñas piezas de Python deterministas, escritas en el dashboard y ejecutadas en la flota de evaluadores de Failproof AI. La lógica más pesada — un juez LLM, un paquete, un secreto, una llamada de red — se ejecuta en tu propio worker.

Generar a partir de una descripción

  1. Ve a Analyze → eval authoring y selecciona new eval.
  2. Describe qué medir en lenguaje natural, o elige entre start from an example…, y selecciona draft.
  3. Revisa los campos y el código que se rellena automáticamente, luego pruébalo y despliégalo.
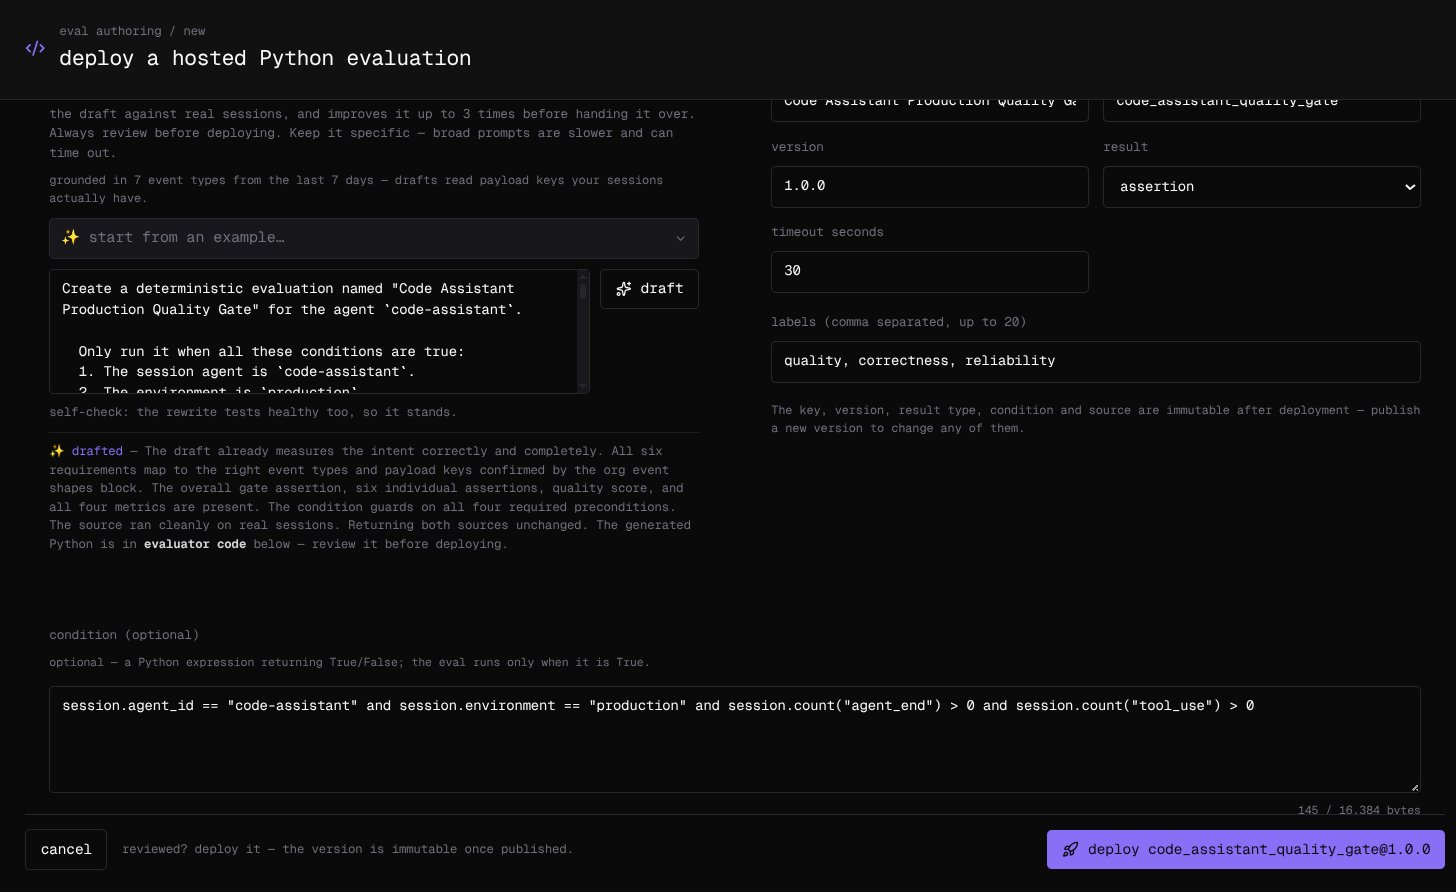
La página de creación de evaluaciones con una evaluación generada: la descripción, las notas del asistente sobre el borrador y los campos de nombre, clave, versión, resultado, timeout, etiquetas y condición. El borrador se basa en los eventos propios de tu organización: la página lee qué claves de payload llevaban tus sesiones durante los últimos siete días, de modo que el código usa claves que existen en lugar de suposiciones. Antes de entregar el borrador, el asistente lo prueba contra hasta cinco de tus sesiones recientes, corrige todo lo que pueda demostrar que está roto — hasta tres rondas — y verifica una vez que el código mide lo que pediste. Mantén la descripción específica: los prompts amplios son más lentos y pueden agotar el tiempo de espera. Revisa el código de todas formas; el despliegue nunca está bloqueado.

Configurar los campos

Usa la condición para limitar el alcance de una evaluación a los agentes y entornos para los que está pensada:
La clave, la versión, el tipo de resultado, la condición y el código son inmutables una vez desplegados: para cambiar cualquiera de ellos, publica una nueva versión. El nombre, las etiquetas y si está habilitada siguen siendo editables.

Escribir el código tú mismo

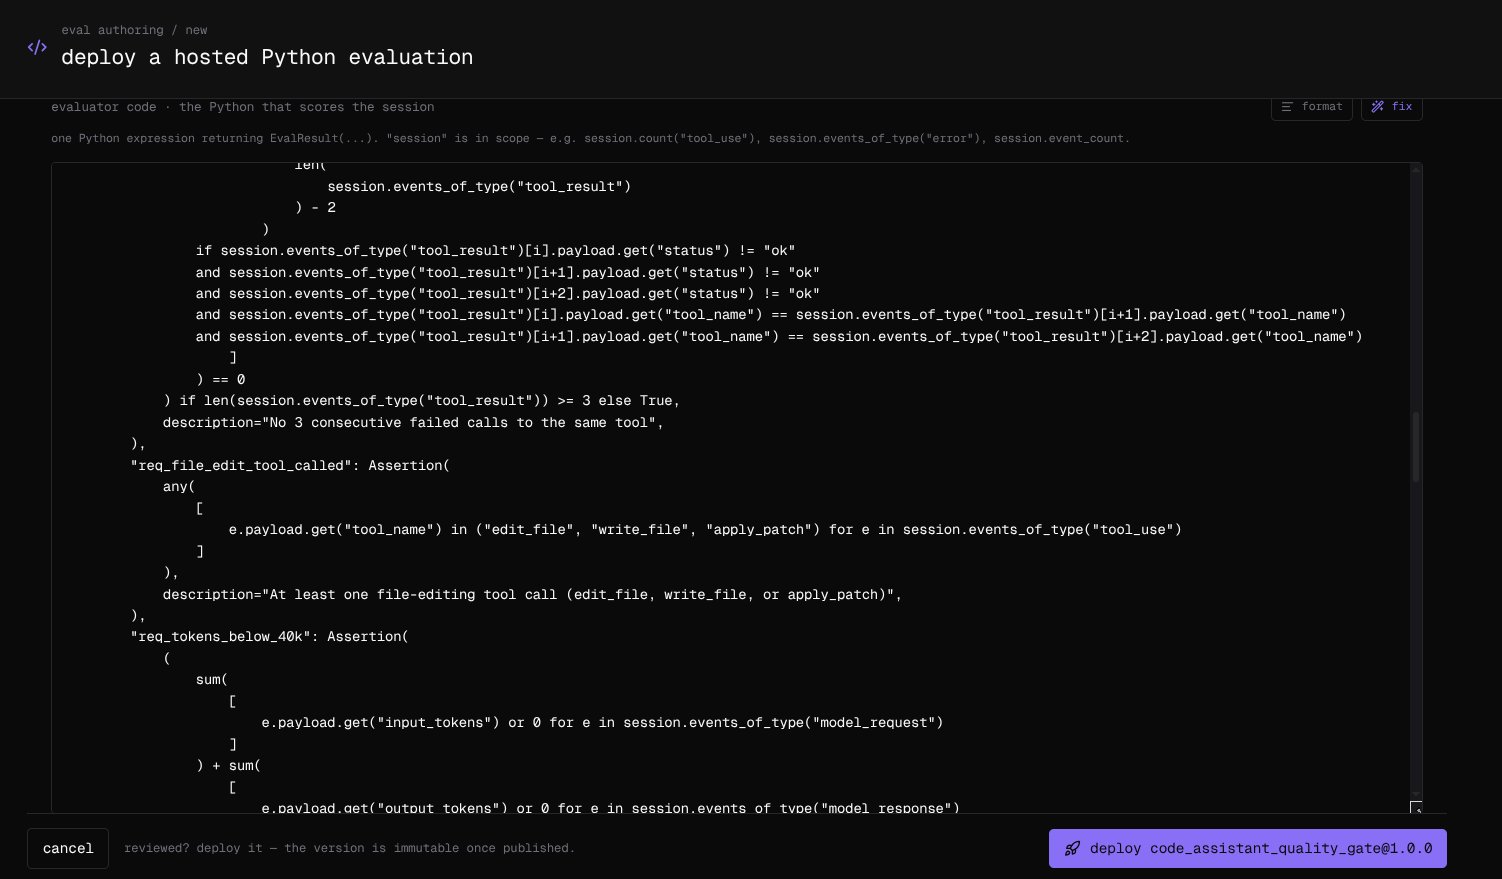
El evaluator code es una expresión Python que devuelve EvalResult(...), con session en el ámbito. Esta expresión calcula la proporción de resultados de herramientas que volvieron correctamente:
Un resultado encabeza con la propia clave de la evaluación, en su tipo declarado: score= para una evaluación de puntuación, o una entrada metrics o assertions con el nombre de la clave para una métrica o una aserción. Otras métricas y aserciones se incluyen junto a ella, con hasta 25 resultados por ejecución. No hay nada más accesible: sin imports y sin atributos más allá de los datos de sesión y los métodos simples de cadenas y diccionarios como get, lower y split, que deben invocarse en lugar de referenciarse. Las claves de payload son las que envíen tus agentes — status más arriba es solo un ejemplo — así que léelas desde una sesión real. format ordena el código y fix le pide al asistente que lo repare. El código puede tener hasta 128 KiB, y la condición hasta 16 KiB. El editor de código del evaluador, con format y fix, mostrando las aserciones de una evaluación generada.
Escribirlo en tu propio worker

Cuando una evaluación necesita un modelo, un paquete, un secreto o la red, escríbela con el Evaluator SDK y ejecútala en tu propia infraestructura. Usa los mismos tipos de resultado, y sus resultados aparecen junto a los alojados, etiquetados como customer: