Guida agli agenti personalizzati
Installazione, strumentazione, i metodi degli eventi, un esempio pratico e problemi comuni.
Usi un framework?
LangChain, CrewAI, LlamaIndex e Pydantic AI si strumentano da soli con una sola chiamata.
Installazione
failproofai-sdk e importato in Python come failproofai_sdk. I framework extra come failproofai-sdk[langgraph] installano il framework stesso; gli adattatori sono sempre inclusi nella wheel di base.
Connetti il daemon Failproof
- Dashboard
- CLI
-
Vai a Admin → Keys e crea una chiave con
events:add. - Connetti il daemon Failproof al Cloud sulla macchina dell’agente.
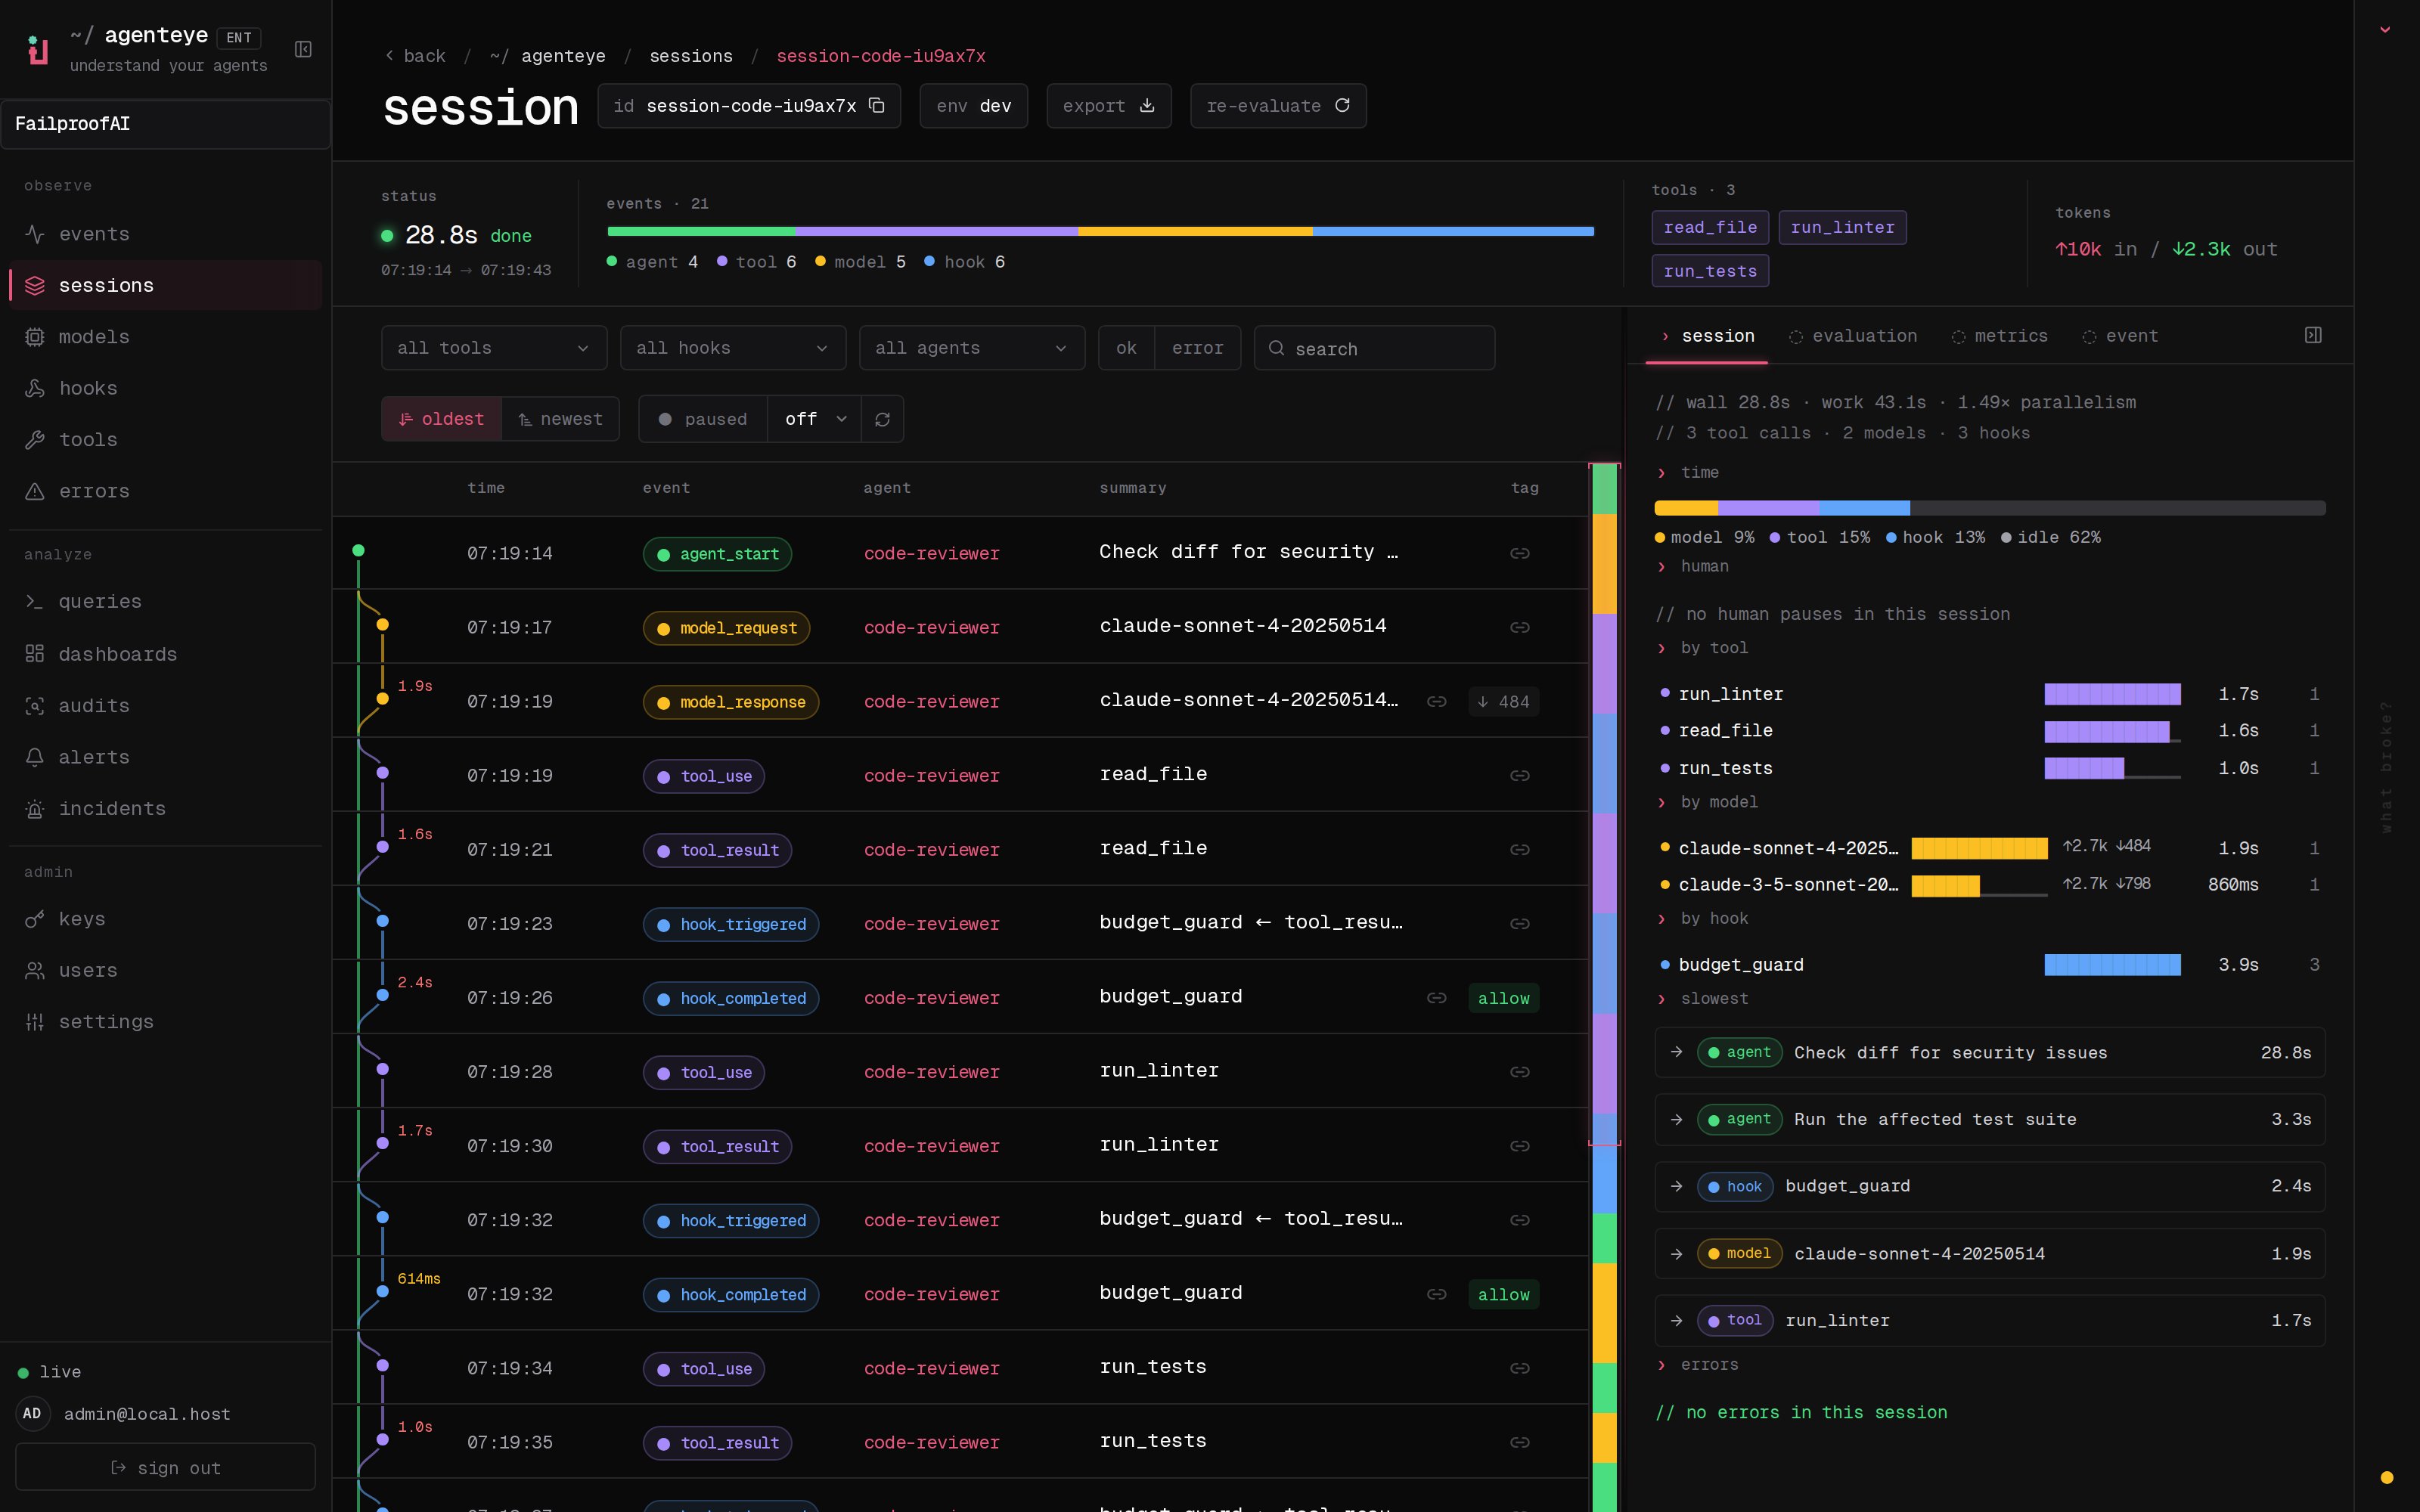
- Esegui una sessione strumentata, quindi trova il suo ID esatto in Observe → Events.
-
Vai a Observe → Sessions, seleziona lo stesso ambiente e apri la traccia ricostruita.
Configurazione
Imposta tramite variabile d’ambiente invece:
Gli eventi sono accodati in memoria e scritti in background ogni
flush_interval secondi, con un flush finale all’uscita dell’interprete. Un processo ucciso bruscamente perde tutto ciò che non era stato ancora scritto.
Identità
Ogni evento appartiene a una sessione e un agente. Gli scope compilano entrambi, quindi raramente li passi:session_id o agent_id esplicitamente funziona ancora e prevale. Senza né binding né passaggio, la chiamata solleva TypeError anziché emettere un evento che Cloud scapterebbe silenziosamente.
L’identità si basa su variabili di contesto. Segue automaticamente i task
asyncio, ma non i nuovi thread — avvolgi un worker in failproofai_sdk.propagate() o i suoi eventi finiscono scollati.Catalogo degli eventi
Quindici metodi. La maggior parte vengono in coppie — chiami l’apertura, quindi la chiusura, e l’SDK misura l’intervallo.
Tre sono indipendenti:
error, human_pause, human_interrupt.
Ogni campo, per metodo
Ogni campo, per metodo
Ogni metodo accetta anche
session_id e agent_id, che gli scope compilano per te. Qualsiasi cosa lasciata come None viene scartata anziché essere inviata come JSON null, e ogni metodo restituisce None.Associazione e durata
Una regola: dai all’evento di chiusura lo stesso id del suo apertura. È questo che li associa e che consente all’SDK di misurare l’intervallo.
Non passare
duration_ms tu stesso. L’SDK lo misura e passarlo solleva ValueError.
L’unica eccezione è model_response, dove solo tu conosci la vera latenza del provider. Passa un numero intero di millisecondi — un float solleva un errore perché la colonna è un intero a 32 bit e altrimenti atterrerebbe vuota.
Casi limite
Casi limite
- Gli id devono essere univoci solo per tipo, per sessione. Una chiamata di strumento e un hook possono condividerne uno; due sessioni in esecuzione contemporaneamente possono riutilizzare gli stessi id senza collisioni.
- Non sono scoped a un agente. Una coppia aperta sotto un agente e chiusa sotto un altro corrisponde ancora — che è il caso normale nel codice multi-agente.
request_idè opzionale ma consigliato. Senza di esso, gli eventi del modello si associano nell’ordine in cui arrivano, quindi due chiamate simultanee nello stesso agente possono associarsi male.- Una coppia divisa tra processi corrisponde ancora nel Cloud, ma l’SDK non può misurarla — nulla in entrambi i processi ha visto entrambe le metà.
- Al massimo 10.000 aperture attendono una chiusura contemporaneamente. Oltre questo la più vecchia viene scartata, quindi una perdita non può crescere senza limiti.
I tuoi campi personalizzati
Qualsiasi extra keyword che passi viene archiviato con l’evento:Decimal, un set, bytes, un oggetto modello — viene archiviata come stringa.
Questi cinque nomi sono riservati e rifiutati completamente: timestamp, session_id, agent_id, type, environment.
Consegnare e verificare
- Dashboard
- CLI
In Observe → Events, verifica che
agent_start esista prima e agent_end esista per ultimo. Quindi apri Observe → Sessions e conferma che gli eventi di modello, strumento, umano, hook e errore appaiano nell’ordine previsto. Usa l’ID sessione come chiave di risoluzione dei problemi principale.$FAILPROOFAI_HOME/custom-agents/events, altrimenti ~/.failproofai/custom-agents/events. I file JSONL provano l’emissione dell’SDK; uno spool crescente indica un daemon o una consegna configurazione, mentre uno spool vuoto indica un’instrumentazione o una durata del processo.
Ispeziona lo spool solo quando il daemon è arrestato. Mentre è in esecuzione, raccoglie ed elimina ogni batch entro millisecondi, quindi un elenco di directory corre con il collezionista e mostra molti meno eventi di quelli che sono stati emessi.