ホスト型評価は、ダッシュボードで記述してFailproof AIのエバリュエーターフリート上で実行される、小さな決定論的なPythonコードです。より重い処理(LLMジャッジ、パッケージ、シークレット、ネットワーク呼び出しなど)は、代わりにお客様自身のワーカー上で実行されます。

説明から下書きを作成する

  1. Analyze → eval authoring に移動し、new eval を選択します。
  2. 測定内容を平易な英語で説明するか、start from an example… から選択して、draft を選択します。
  3. フィールドと自動入力されたコードを確認し、テストしてデプロイします。
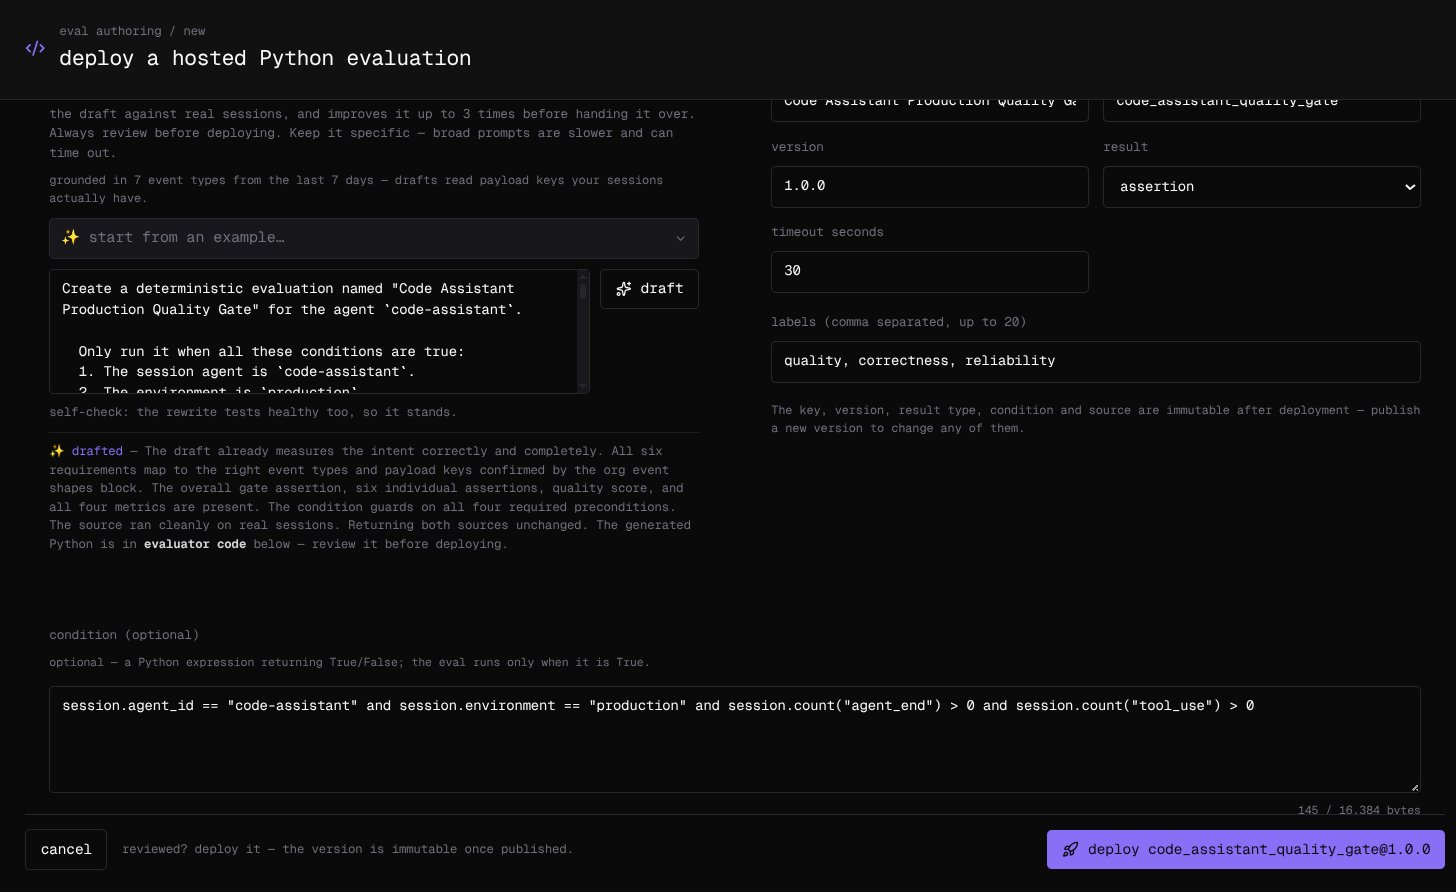
下書きされた評価が表示されたeval authoringページ:説明、下書きに関するアシスタントのメモ、name・key・version・result・timeout・labels・conditionの各フィールド。 下書きは組織独自のイベントに基づいています。このページは過去7日間のセッションで使用されたペイロードキーを読み取るため、コードは推測ではなく実際に存在するキーを参照します。下書きを渡す前に、アシスタントは最大5件の最近のセッションに対してテストを行い、最大3ラウンドで修正可能な問題を修正し、コードが要求された内容を測定しているか一度確認します。説明は具体的に記述してください。広範なプロンプトは処理が遅くタイムアウトする場合があります。いずれの場合もコードをレビューしてください。デプロイがブロックされることはありません。

フィールドを設定する

conditionを使用して、評価を対象とするエージェントおよび環境にスコープを絞り込みます:
key、version、result type、condition、コードはデプロイ後は変更不可です。これらを変更する場合は、新しいバージョンを公開してください。name、labels、および有効/無効の状態は引き続き編集可能です。

コードを自分で記述する

evaluator codeEvalResult(...) を返す1つのPython式で、スコープ内に session があります。以下の例は、ステータスがokで返ってきたツール結果の割合を採点します:
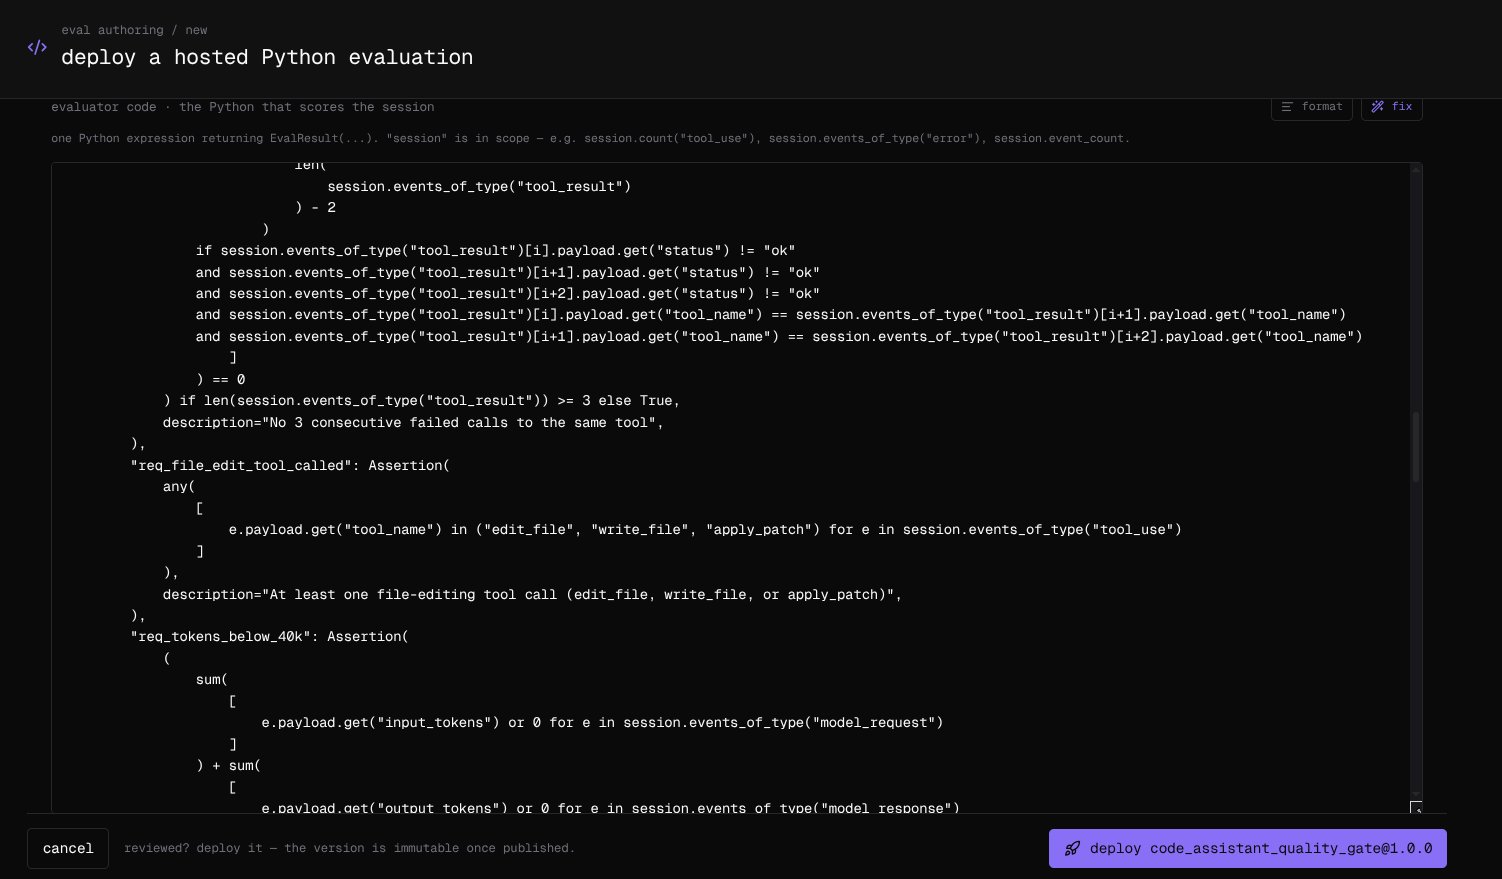
結果は、評価自身のキーを宣言された型でリードします。score評価には score=、metric評価またはassertion評価にはキーと同じ名前の metrics または assertions エントリを使用します。その他のmetricsとassertionsはこれに付随し、1回の実行で最大25件の結果を含められます。 それ以外にはアクセスできません。importは使用できず、セッションデータとプレーンな文字列・辞書メソッド(getlowersplit など、参照ではなく呼び出しが必要)以外の属性も使用できません。ペイロードキーはエージェントが送信する内容によって異なります(上記の status はあくまで例です)。実際のセッションから確認してください。format はコードを整形し、fix はアシスタントに修正を依頼します。コードは最大128 KiB、conditionは最大16 KiBです。 evaluatorコードエディター。formatとfixが表示され、下書きされた評価のassertionsを示している。
お客様自身のワーカーで記述する

評価にモデル、パッケージ、シークレット、またはネットワークが必要な場合は、Evaluator SDK を使用して記述し、お客様自身のインフラストラクチャ上で実行します。同じ結果型を使用し、その結果はホスト型の結果の隣に customer タグ付きで表示されます: