

Avaliações hospedadas são pequenos scripts Python determinísticos, escritos no dashboard e executados na frota de avaliadores da Failproof AI. Lógicas mais pesadas — um juiz LLM, um pacote, um segredo, uma chamada de rede — rodam no seu próprio worker.

Criar a partir de uma descrição

  1. Acesse Analyze → eval authoring e selecione new eval.
  2. Descreva o que medir em linguagem natural, ou escolha em start from an example…, e selecione draft.
  3. Revise os campos e o código gerado, depois teste e publique.
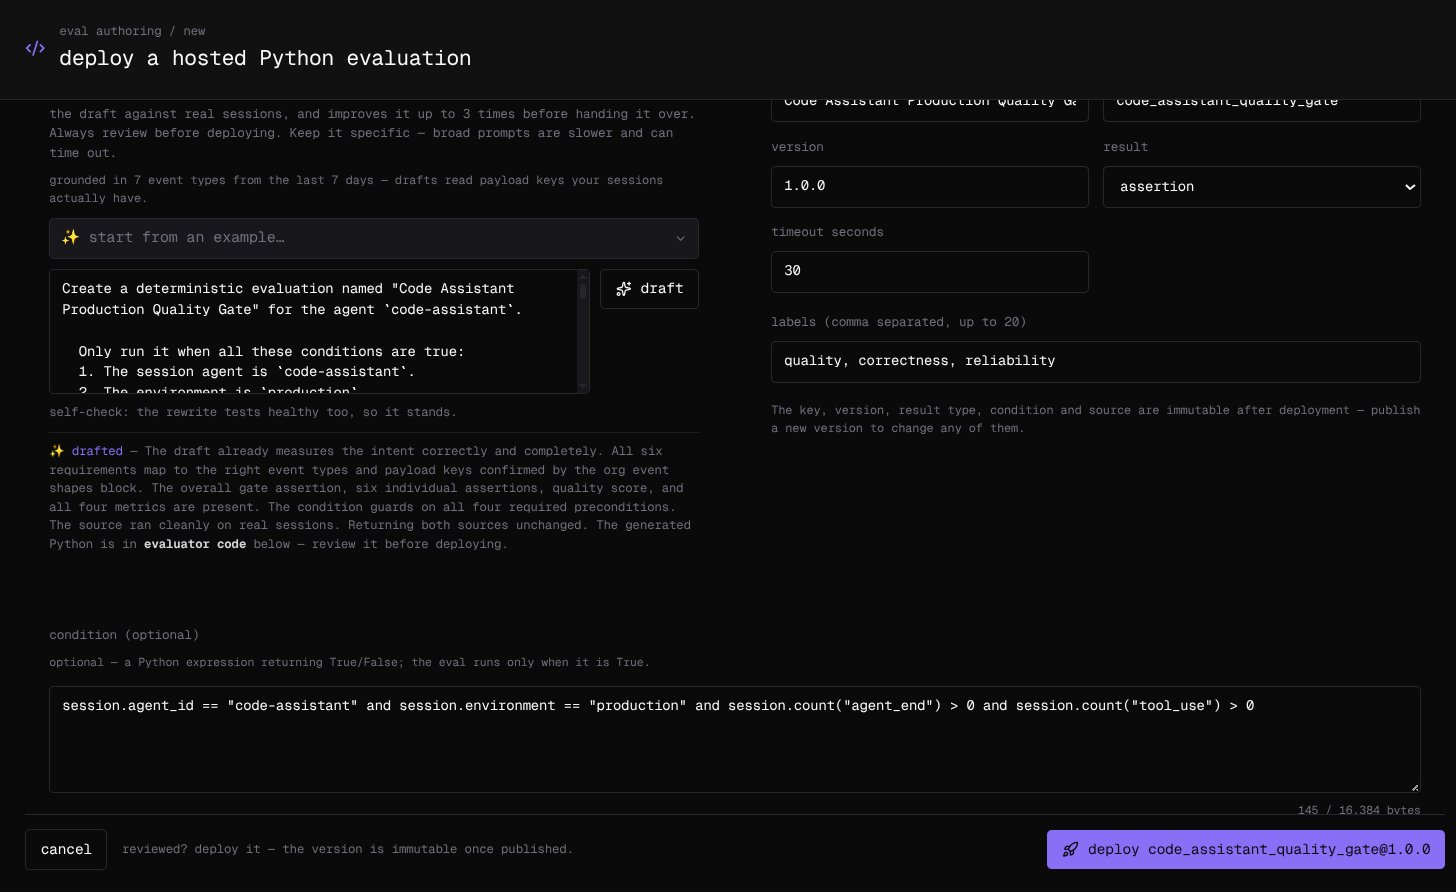
A página de criação de avaliações com uma avaliação gerada: a descrição, as notas do assistente sobre o rascunho e os campos de nome, chave, versão, resultado, timeout, labels e condição. O rascunho é baseado nos eventos da sua própria organização: a página lê quais chaves de payload suas sessões carregaram nos últimos sete dias, de modo que o código use chaves reais em vez de suposições. Antes de entregar o rascunho, o assistente o testa em até cinco das suas sessões recentes, corrige tudo o que conseguir provar estar errado — em até três rodadas — e verifica se o código mede o que você pediu. Seja específico na descrição: prompts amplos são mais lentos e podem ultrapassar o tempo limite. De qualquer forma, revise o código; a publicação nunca é bloqueada.

Configurar os campos

Use a condição para restringir uma avaliação aos agentes e ambientes para os quais ela foi criada:
A chave, versão, tipo de resultado, condição e código são imutáveis após a publicação: para alterar qualquer um deles, publique uma nova versão. O nome, as labels e se está habilitada permanecem editáveis.

Escrever o código você mesmo

O evaluator code é uma única expressão Python que retorna EvalResult(...), com session disponível no escopo. Este exemplo calcula a proporção de resultados de ferramentas que retornaram ok:
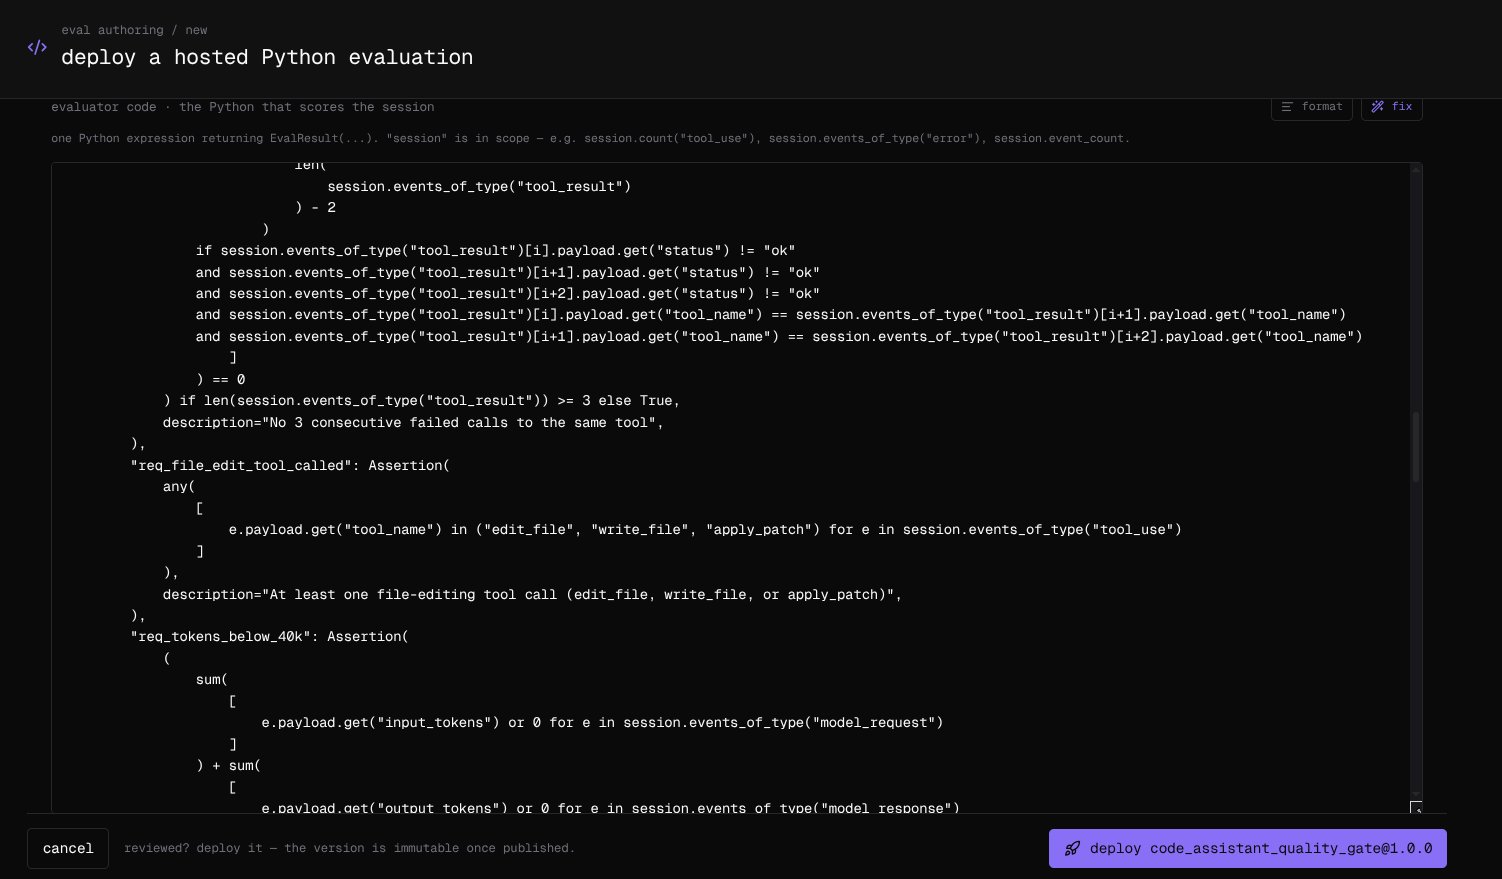
Um resultado começa com a chave da própria avaliação, no tipo declarado: score= para uma avaliação de pontuação, ou uma entrada em metrics ou assertions com o nome da chave para uma avaliação de métrica ou asserção. Outras métricas e asserções podem acompanhá-la, com até 25 resultados por execução. Nada mais está acessível: sem imports, e sem atributos além dos dados de sessão e métodos simples de string e dicionário como get, lower e split, que devem ser chamados e não apenas referenciados. As chaves de payload são o que seus agentes enviam — status acima é apenas um exemplo — portanto, leia-as de uma sessão real. format organiza o código e fix pede ao assistente que o corrija. O código pode ter até 128 KiB, e a condição até 16 KiB. O editor de código do avaliador, com format e fix, exibindo as asserções de uma avaliação gerada.
Escrever no seu próprio worker

Quando uma avaliação precisa de um modelo, um pacote, um segredo ou acesso à rede, escreva-a com o Evaluator SDK e execute-a na sua própria infraestrutura. Ela usa os mesmos tipos de resultado, e seus resultados aparecem ao lado dos hospedados, marcados como customer: