

Guia de agentes customizados
Instalação, instrumentação, métodos de evento, um exemplo completo e problemas comuns.
Usando um framework?
LangChain, CrewAI, LlamaIndex e Pydantic AI se instrumentam com uma única chamada.
Instalação
failproofai-sdk e importado no Python como failproofai_sdk. Extras de framework como failproofai-sdk[langgraph] instalam o próprio framework; os adaptadores sempre estão incluídos no pacote base.
Conectar o daemon do Failproof
- Dashboard
- CLI
-
Acesse Admin → Keys e crie uma chave com
events:add. - Conecte o daemon do Failproof à Cloud na máquina do agente.
- Execute uma sessão instrumentada e encontre o ID exato em Observe → Events.
-
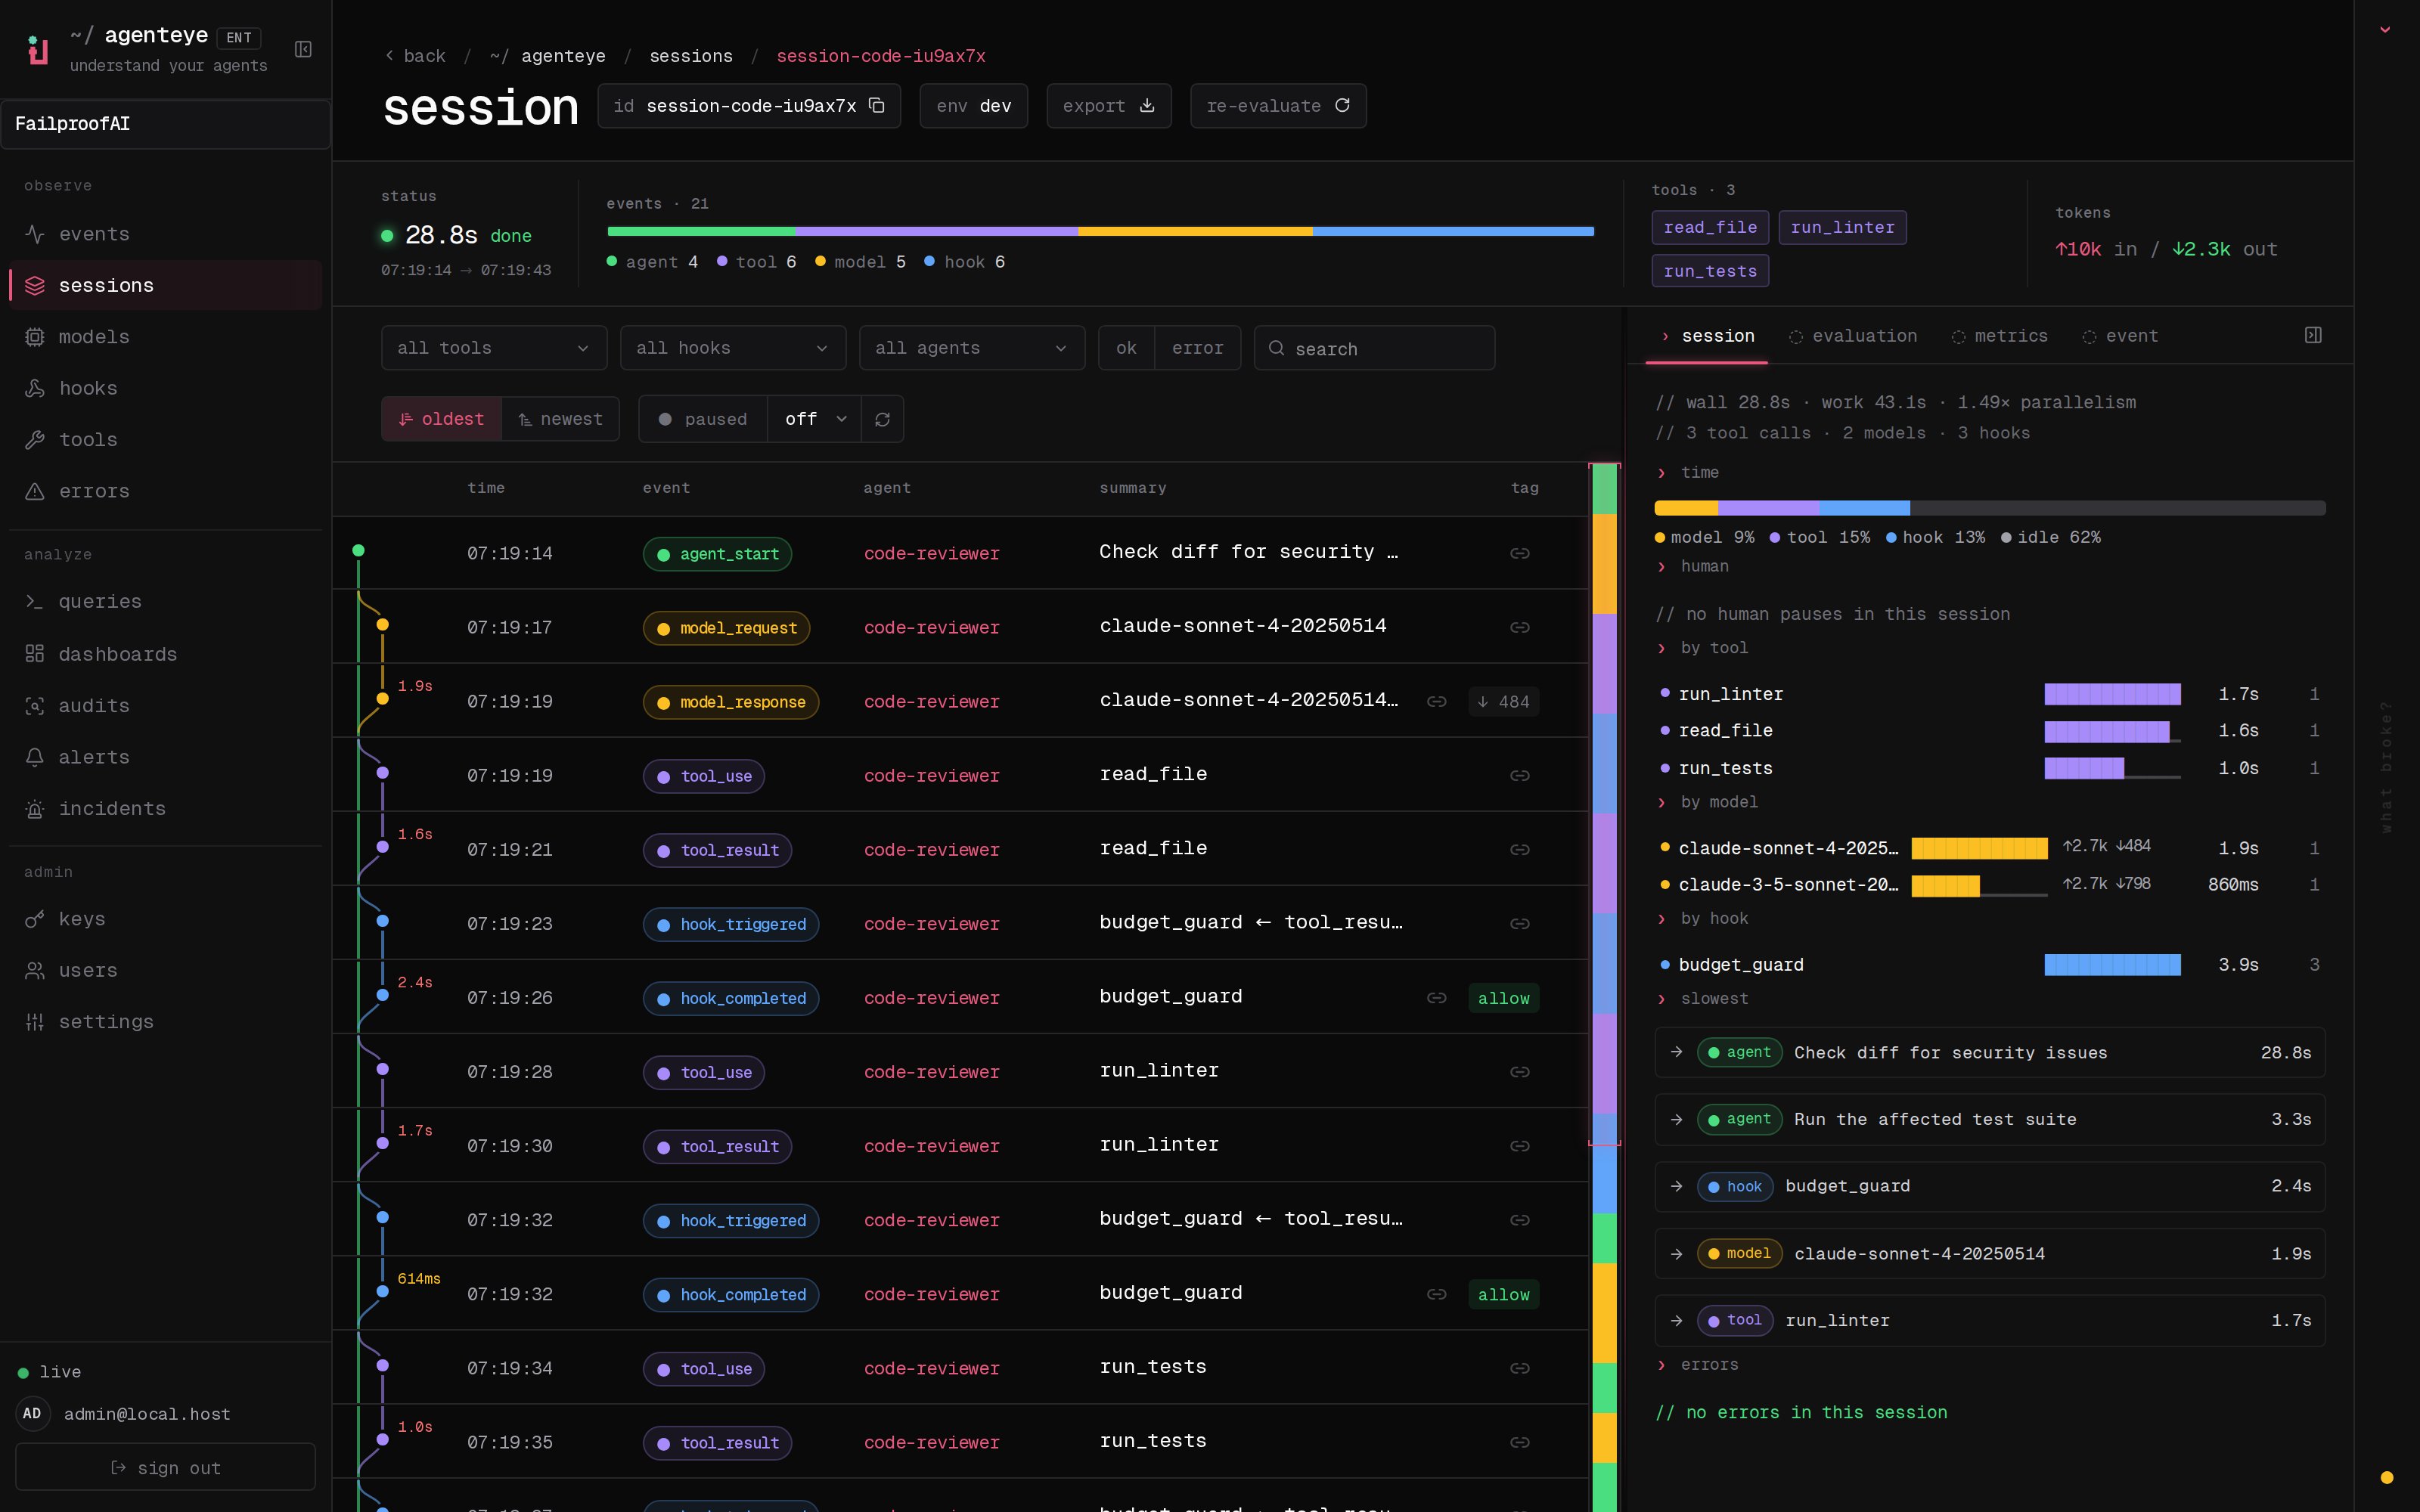
Acesse Observe → Sessions, selecione o mesmo ambiente e abra o trace reconstruído.
Configuração
Configurar via variável de ambiente:
Os eventos são enfileirados em memória e gravados em segundo plano a cada
flush_interval segundos, com um flush final ao encerrar o interpretador. Um processo encerrado abruptamente perde tudo que ainda não havia sido gravado.
Identidade
Todo evento pertence a uma sessão e a um agente. Os escopos preenchem ambos automaticamente, então raramente você precisa passá-los:session_id ou agent_id explicitamente ainda funciona e tem precedência. Se nem um estiver vinculado nem passado, a chamada lança TypeError em vez de emitir um evento que a Cloud descartaria silenciosamente.
A identidade usa variáveis de contexto. Ela segue tasks
asyncio automaticamente, mas não novas threads — envolva um worker com failproofai_sdk.propagate() ou seus eventos serão emitidos sem vínculo.Catálogo de eventos
Quinze métodos. A maioria vem em pares — você chama o abridor e depois o fechador, e o SDK mede o intervalo.
Três são independentes:
error, human_pause, human_interrupt.
Todos os campos por método
Todos os campos por método
Todo método também aceita
session_id e agent_id, que os escopos preenchem automaticamente. Qualquer campo deixado como None é descartado em vez de enviado como null no JSON, e todo método retorna None.Pareamento e duração
Uma regra: passe o mesmo id ao evento de fechamento que foi usado no evento de abertura. É isso que os emparelha e permite ao SDK medir o intervalo.
Não passe
duration_ms manualmente. O SDK o mede, e passá-lo lança ValueError.
A única exceção é model_response, onde somente você conhece a latência real do provedor. Passe um número inteiro de milissegundos — um float lança erro, pois a coluna é um inteiro de 32 bits e ficaria vazia caso contrário.
Casos extremos
Casos extremos
- Os ids precisam ser únicos apenas por tipo e por sessão. Uma chamada de ferramenta e um hook podem compartilhar o mesmo id; duas sessões rodando ao mesmo tempo podem reutilizar os mesmos ids sem conflito.
- Eles não têm escopo por agente. Um par aberto em um agente e fechado em outro ainda é emparelhado corretamente — o que é o caso normal em código multi-agente.
request_idé opcional, mas recomendado. Sem ele, os eventos de modelo são emparelhados na ordem de chegada, então duas chamadas concorrentes no mesmo agente podem ser emparelhadas incorretamente.- Um par dividido entre processos ainda é emparelhado na Cloud, mas o SDK não consegue medir o tempo — nenhum dos processos viu ambas as metades.
- No máximo 10.000 abridores aguardam um fechador ao mesmo tempo. Além disso, o mais antigo é descartado, evitando que um vazamento cresça indefinidamente.
Campos próprios
Qualquer palavra-chave extra que você passar é armazenada junto ao evento:Decimal, set, bytes, objeto de modelo — é armazenado como string.
Estes cinco nomes são reservados e rejeitados diretamente: timestamp, session_id, agent_id, type, environment.
Entrega e verificação
- Dashboard
- CLI
Em Observe → Events, verifique se
agent_start existe primeiro e agent_end existe por último. Em seguida, abra Observe → Sessions e confirme se os eventos de modelo, ferramenta, humano, hook e erro aparecem na ordem esperada. Use o ID da sessão como chave principal de troubleshooting.$FAILPROOFAI_HOME/custom-agents/events, caso contrário ~/.failproofai/custom-agents/events. Arquivos JSONL comprovam a emissão pelo SDK; um spool crescendo indica problema de configuração ou entrega do daemon, enquanto um spool vazio aponta para instrumentação ou tempo de vida do processo.
Inspecione o spool somente quando o daemon estiver parado. Enquanto ele está em execução, ele coleta e exclui cada lote em milissegundos, então uma listagem de diretório disputa com o coletor e mostra muito menos eventos do que foram emitidos.