自定义 Agent 指南
安装、埋点、事件方法、完整示例及常见问题。
使用框架?
LangChain、CrewAI、LlamaIndex 和 Pydantic AI 只需一次调用即可完成自动埋点。
安装
failproofai-sdk,在 Python 中以 failproofai_sdk 导入。failproofai-sdk[langgraph] 等框架扩展会同时安装对应框架本身;适配器始终包含在基础安装包中。
连接 Failproof 守护进程
- 控制台
- CLI
-
前往 Admin → Keys,创建一个具有
events:add权限的密钥。 - 在 Agent 所在机器上将 Failproof 守护进程连接到 Cloud。
- 运行一次已埋点的会话,然后在 Observe → Events 下找到其确切 ID。
-
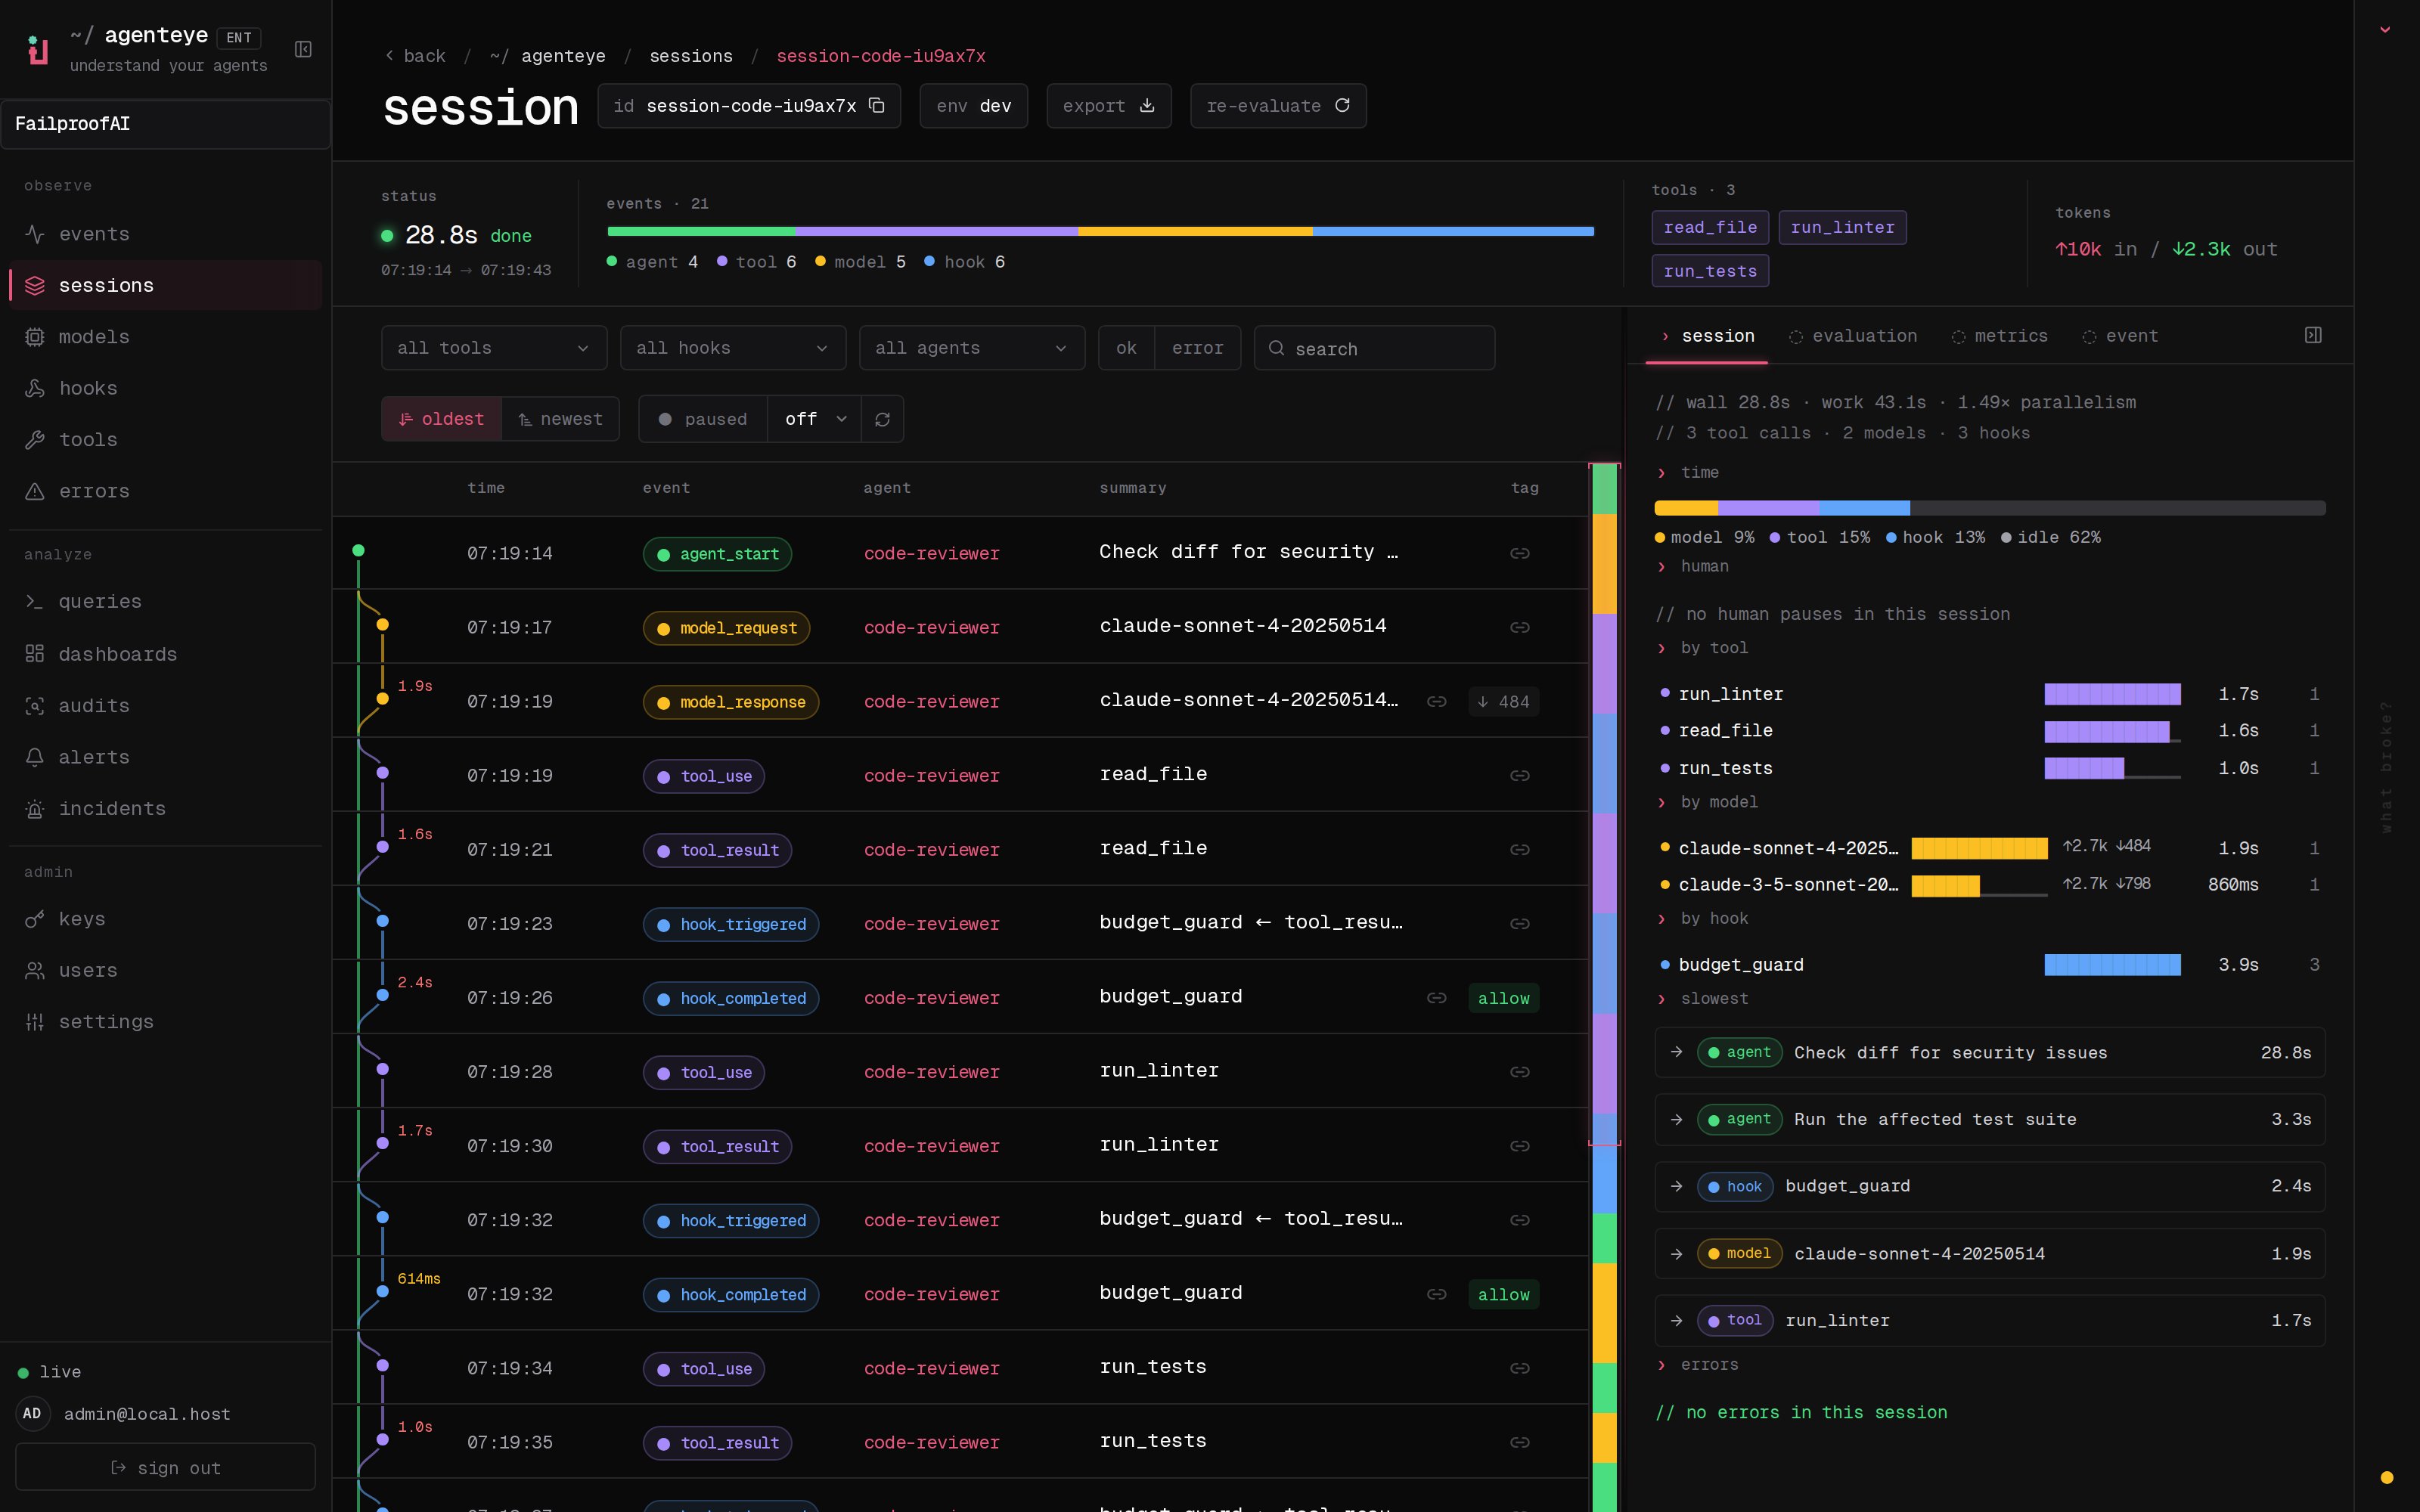
前往 Observe → Sessions,选择相同的环境,打开重建后的追踪记录。
配置
也可通过环境变量进行配置:
事件先在内存中排队,每隔
flush_interval 秒由后台线程写入,解释器退出时执行最终刷写。进程被强制终止时,尚未写入的事件将会丢失。
身份标识
每个事件都归属于一个会话和一个 agent。作用域会自动填充两者,因此通常无需手动传入:session_id 或 agent_id 也完全有效,且优先级更高。如果既没有绑定作用域,也没有手动传入,调用将抛出 TypeError,而不是发出一个 Cloud 会静默丢弃的事件。
身份标识基于上下文变量传递,会自动跟随
asyncio 任务,但不会跟随新线程——请使用 failproofai_sdk.propagate() 包装工作线程,否则其事件将无法关联到对应会话。事件目录
共 15 个方法,大多数成对出现——调用开始方法,再调用结束方法,SDK 会自动计算两者之间的耗时。
另有三个独立方法:
error、human_pause、human_interrupt。
每个方法的完整字段说明
每个方法的完整字段说明
每个方法同样接受
session_id 和 agent_id 参数,由作用域自动填充。值为 None 的字段会被丢弃,不会以 JSON null 形式发送;所有方法均返回 None。配对与耗时
一条规则:结束事件必须与其对应的开始事件使用相同的 ID。 这是配对的依据,也是 SDK 计算耗时的方式。
不要自行传入
duration_ms。 SDK 会自动测量,手动传入会抛出 ValueError。
唯一的例外是 model_response——只有你才知道真实的 provider 延迟。请传入整数毫秒值,浮点数会导致抛出异常,因为该字段是 32 位整数,传入浮点数会导致数据丢失。
边界情况
边界情况
- ID 只需在同类事件、同一会话内唯一。 一个工具调用和一个 hook 可以共用同一个 ID;同时运行的两个会话可以复用相同的 ID 而不会发生冲突。
- ID 不限定于某个 agent 的作用域。 在一个 agent 下打开、在另一个 agent 下关闭的配对仍然可以匹配——这在多 agent 代码中是正常情况。
request_id可选,但推荐填写。 不填时,模型事件按到达顺序配对,同一 agent 内的两个并发调用可能会错误配对。- 跨进程的配对在 Cloud 中仍然可以匹配,但 SDK 无法计算耗时——因为没有任何一个进程同时看到了两半。
- 最多同时等待 10,000 个待配对的开始事件。 超出后最旧的会被丢弃,防止内存泄漏无限增长。
自定义字段
额外传入的关键字参数会随事件一起存储:Decimal、set、bytes、模型对象等——将以字符串形式存储。
以下五个字段名为保留字,会被直接拒绝:timestamp、session_id、agent_id、type、environment。
数据投递与验证
- 控制台
- CLI
在 Observe → Events 中,先确认存在
agent_start 事件,最后存在 agent_end 事件。然后打开 Observe → Sessions,确认模型、工具、人工、hook 和错误事件按预期顺序出现。排查问题时以 session ID 作为主要索引。$FAILPROOFAI_HOME/custom-agents/events,否则检查 ~/.failproofai/custom-agents/events。JSONL 文件的存在可证明 SDK 已成功发出事件;spool 持续增大说明问题在守护进程配置或数据投递环节;spool 为空则说明问题在埋点或进程生命周期管理上。
仅在守护进程停止时才检查 spool。守护进程运行期间,它会在毫秒内收集并删除每批数据,因此目录列表会与收集器产生竞争,显示的事件数量将远少于实际发出的数量。