Guía de agentes personalizados
Instalación, instrumentación, métodos de evento, un ejemplo completo y problemas frecuentes.
¿Usas un framework?
LangChain, CrewAI, LlamaIndex y Pydantic AI se instrumentan solos con una sola llamada.
Instalar
failproofai-sdk y se importa en Python como failproofai_sdk. Los extras de framework como failproofai-sdk[langgraph] instalan el propio framework; los adaptadores siempre vienen incluidos en el wheel base.
Conectar el daemon de Failproof
- Dashboard
- CLI
-
Ve a Admin → Keys y crea una clave con
events:add. - Conecta el daemon de Failproof a Cloud en la máquina del agente.
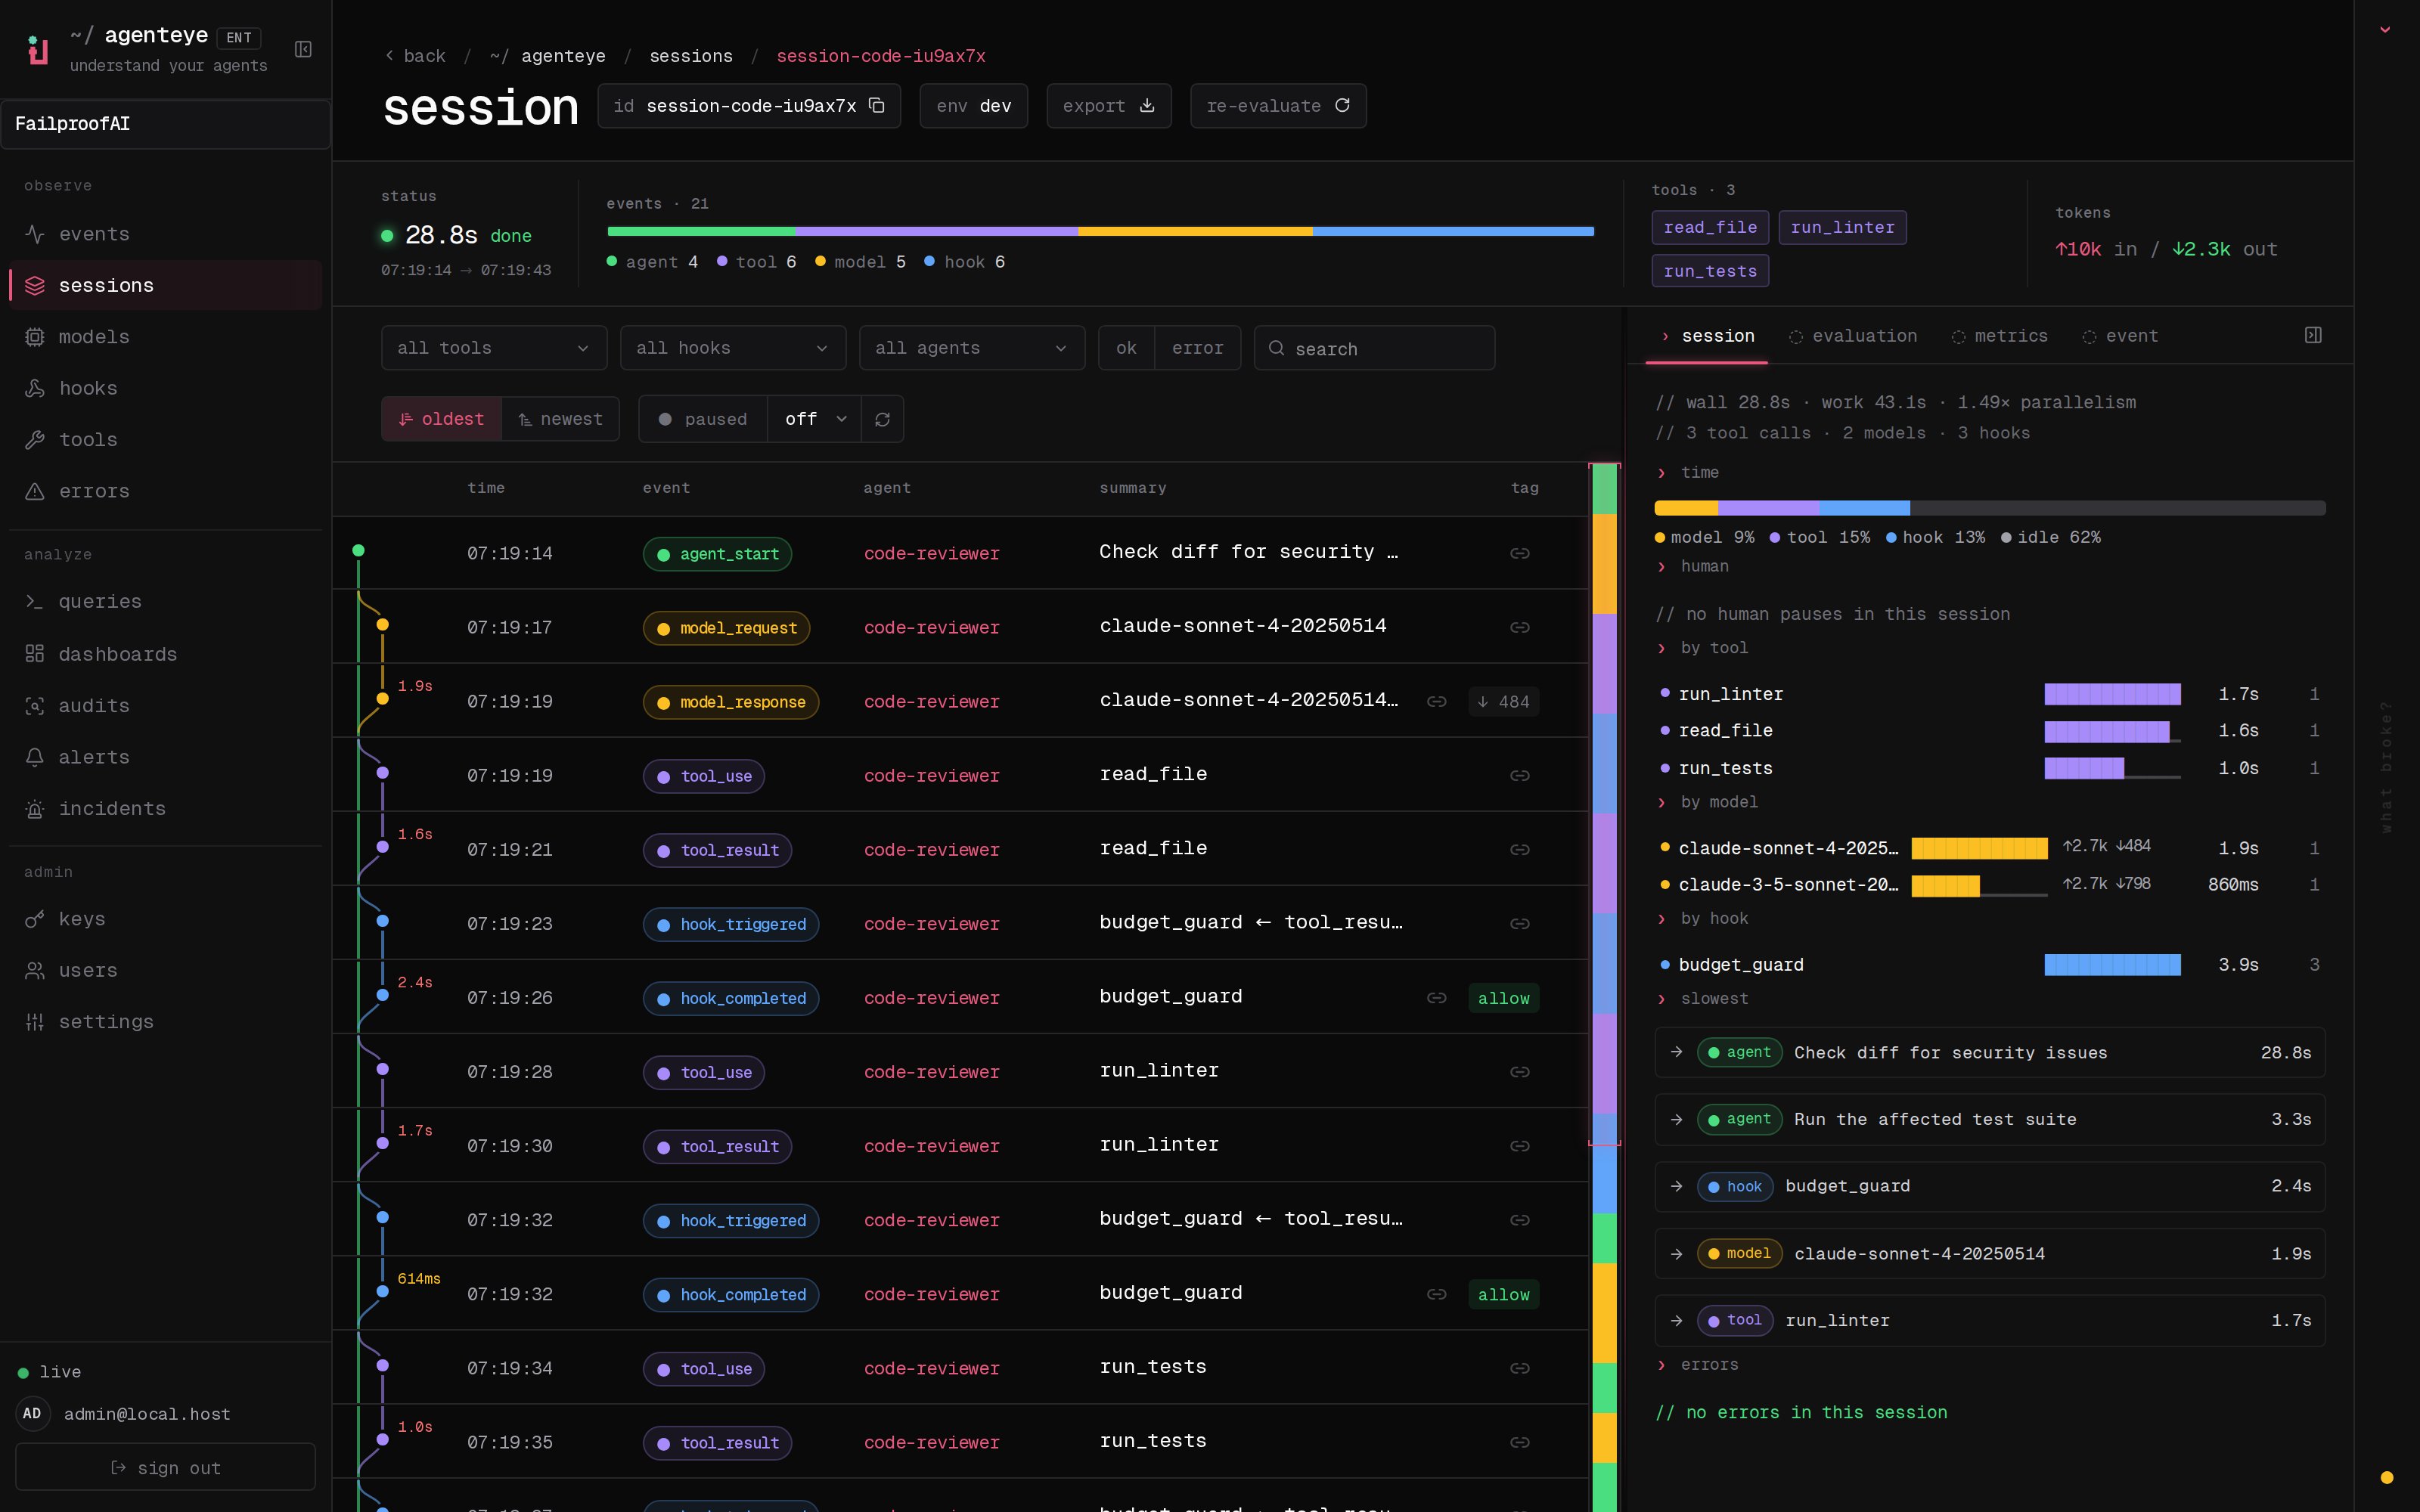
- Ejecuta una sesión instrumentada y luego busca su ID exacto en Observe → Events.
-
Ve a Observe → Sessions, selecciona el mismo entorno y abre el trace reconstruido.
Configuración
Configurable también mediante variables de entorno:
Los eventos se encolan en memoria y se escriben en segundo plano cada
flush_interval segundos, con un flush final al salir del intérprete. Un proceso que se cierra abruptamente pierde todo lo que no se había escrito todavía.
Identidad
Cada evento pertenece a una sesión y a un agente. Los scopes rellenan ambos automáticamente, así que raramente necesitas pasarlos:session_id o agent_id explícitamente sigue funcionando y tiene prioridad. Si no hay ninguno vinculado ni pasado, la llamada lanza TypeError en lugar de emitir un evento que Cloud descartaría silenciosamente.
La identidad viaja en variables de contexto. Sigue las tareas de
asyncio automáticamente, pero no los hilos nuevos — envuelve un worker con failproofai_sdk.propagate() o sus eventos quedarán sin asociar.Catálogo de eventos
Quince métodos. La mayoría vienen en pares — llamas al de apertura, luego al de cierre, y el SDK mide el tiempo entre ambos.
Tres son independientes:
error, human_pause, human_interrupt.
Todos los campos, por método
Todos los campos, por método
Cada método también acepta
session_id y agent_id, que los scopes rellenan por ti. Todo lo que quede como None se omite en lugar de enviarse como JSON null, y todos los métodos devuelven None.Emparejamiento y duración
Una sola regla: dale al evento de cierre el mismo ID que al de apertura. Eso es lo que los empareja y lo que permite al SDK medir el tiempo transcurrido.
No pases
duration_ms tú mismo. El SDK lo mide, y pasarlo lanza ValueError.
La única excepción es model_response, donde solo tú conoces la latencia real del proveedor. Pasa un número entero de milisegundos — un float lanza una excepción, porque la columna es un entero de 32 bits y de otro modo quedaría vacía.
Casos límite
Casos límite
- Los IDs solo necesitan ser únicos por tipo y por sesión. Una llamada a una herramienta y un hook pueden compartir el mismo ID; dos sesiones que se ejecuten a la vez pueden reutilizar los mismos IDs sin colisionar.
- No están vinculados a un agente. Un par abierto bajo un agente y cerrado bajo otro sigue emparejándose, que es el caso habitual en código multi-agente.
request_ides opcional pero recomendable. Sin él, los eventos de modelo se emparejan en el orden en que llegan, por lo que dos llamadas concurrentes en el mismo agente pueden emparejarse incorrectamente.- Un par dividido entre procesos sigue emparejándose en Cloud, pero el SDK no puede medirlo — ningún proceso vio ambas mitades.
- Como máximo 10 000 aperturas pueden esperar un cierre a la vez. A partir de ahí, se descarta la más antigua, de modo que una fuga no puede crecer sin límite.
Tus propios campos
Cualquier argumento adicional que pases se almacena junto al evento:Decimal, un set, bytes, un objeto de modelo — se almacena como cadena de texto.
Estos cinco nombres están reservados y se rechazan directamente: timestamp, session_id, agent_id, type, environment.
Entrega y verificación
- Dashboard
- CLI
En Observe → Events, verifica que
agent_start existe primero y agent_end existe al final. Luego abre Observe → Sessions y confirma que los eventos de modelo, herramienta, humano, hook y error aparecen en el orden esperado. Usa el ID de sesión como clave principal para depurar.$FAILPROOFAI_HOME/custom-agents/events; de lo contrario, ~/.failproofai/custom-agents/events. Los archivos JSONL confirman la emisión por parte del SDK; un spool que crece apunta a un problema de configuración o entrega del daemon, mientras que un spool vacío apunta a la instrumentación o al ciclo de vida del proceso.
Inspecciona el spool solo cuando el daemon esté detenido. Mientras está en ejecución, recoge y elimina cada lote en milisegundos, por lo que un listado del directorio compite con el colector y mostrará muchos menos eventos de los que realmente se emitieron.