

Размещённые оценки — это небольшие детерминированные программы на Python, написанные в панели управления и выполняемые на оценочном кластере Failproof AI. Более сложную логику — судью на основе LLM, пакет, секрет, сетевой запрос — лучше запустить в вашем собственном воркере.

Составить оценку из описания

  1. Перейдите в Analyze → eval authoring и выберите new eval.
  2. Опишите, что нужно измерить, на простом английском языке или выберите start from an example…, затем нажмите draft.
  3. Проверьте поля и сгенерированный код, потом протестируйте его и разверните.
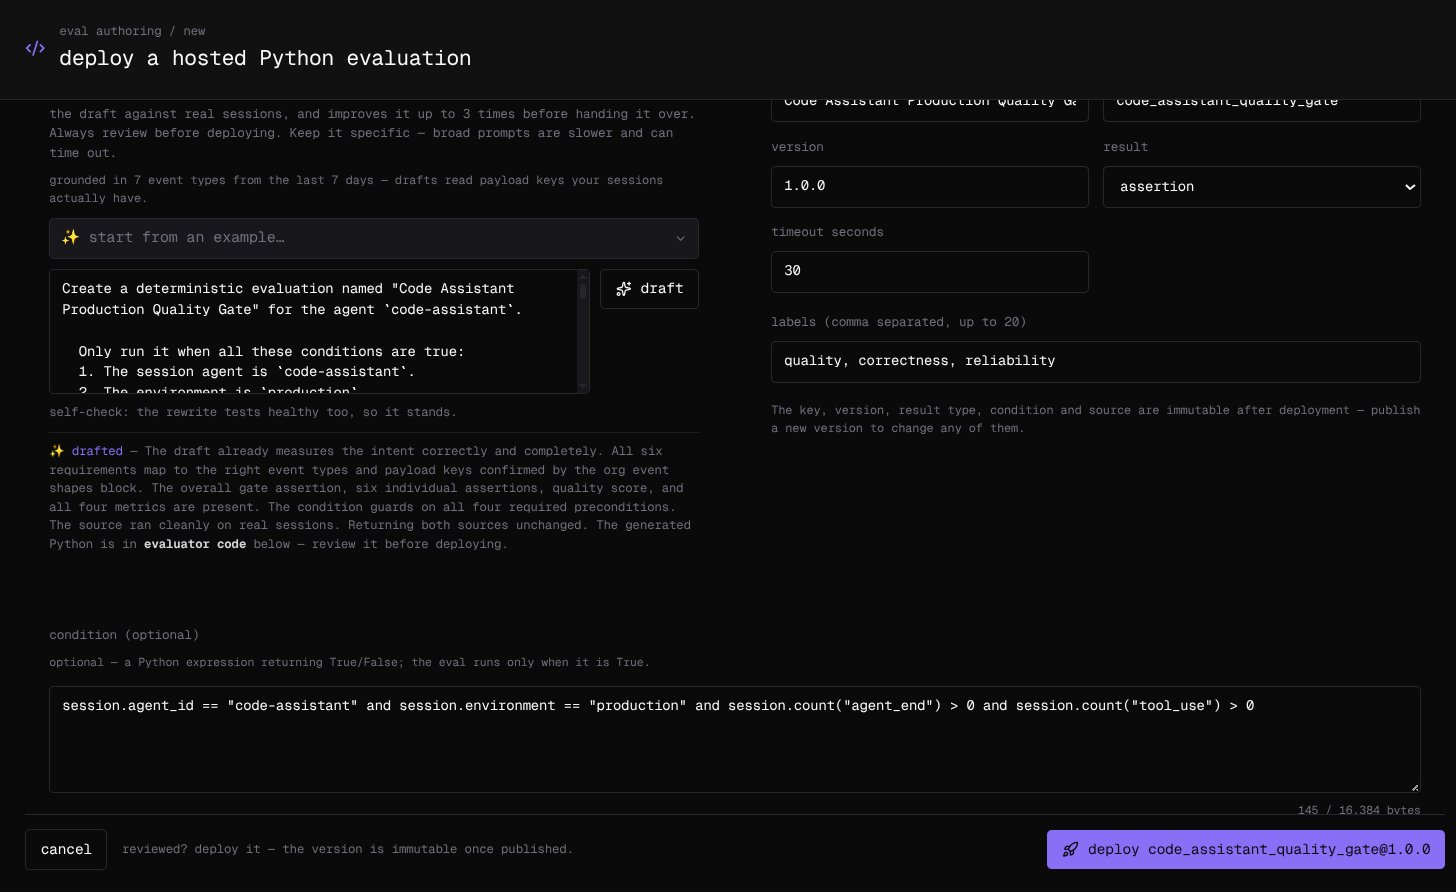
Страница создания оценки с составленной оценкой: описание, заметки помощника о черновике, поля имени, ключа, версии, результата, тайм-аута, меток и условия. Черновик основан на событиях вашей организации: страница определяет, какие ключи полезной нагрузки были в ваших сессиях за последние семь дней, поэтому код читает существующие ключи, а не угадывает. Перед тем как предложить черновик, помощник тестирует его на до пяти недавних сессий, исправляет всё, что он может доказать, что сломано — до трёх раундов — и один раз проверяет, что код измеряет именно то, что вы просили. Делайте описание конкретным: широкие запросы медленнее и могут истечь по времени. Всё равно проверьте код; развёртывание никогда не блокируется.

Установить поля

Используйте условие, чтобы ограничить оценку агентами и средами, для которых она предназначена:
Ключ, версия, тип результата, условие и код неизменяемы после развёртывания: чтобы изменить любое из них, опубликуйте новую версию. Имя, метки и статус включения остаются редактируемыми.

Написать код самостоятельно

Код оценки — это одно выражение на Python, которое возвращает EvalResult(...) с доступным session. Вот пример, который оценивает долю результатов инструмента, которые пришли в порядке:
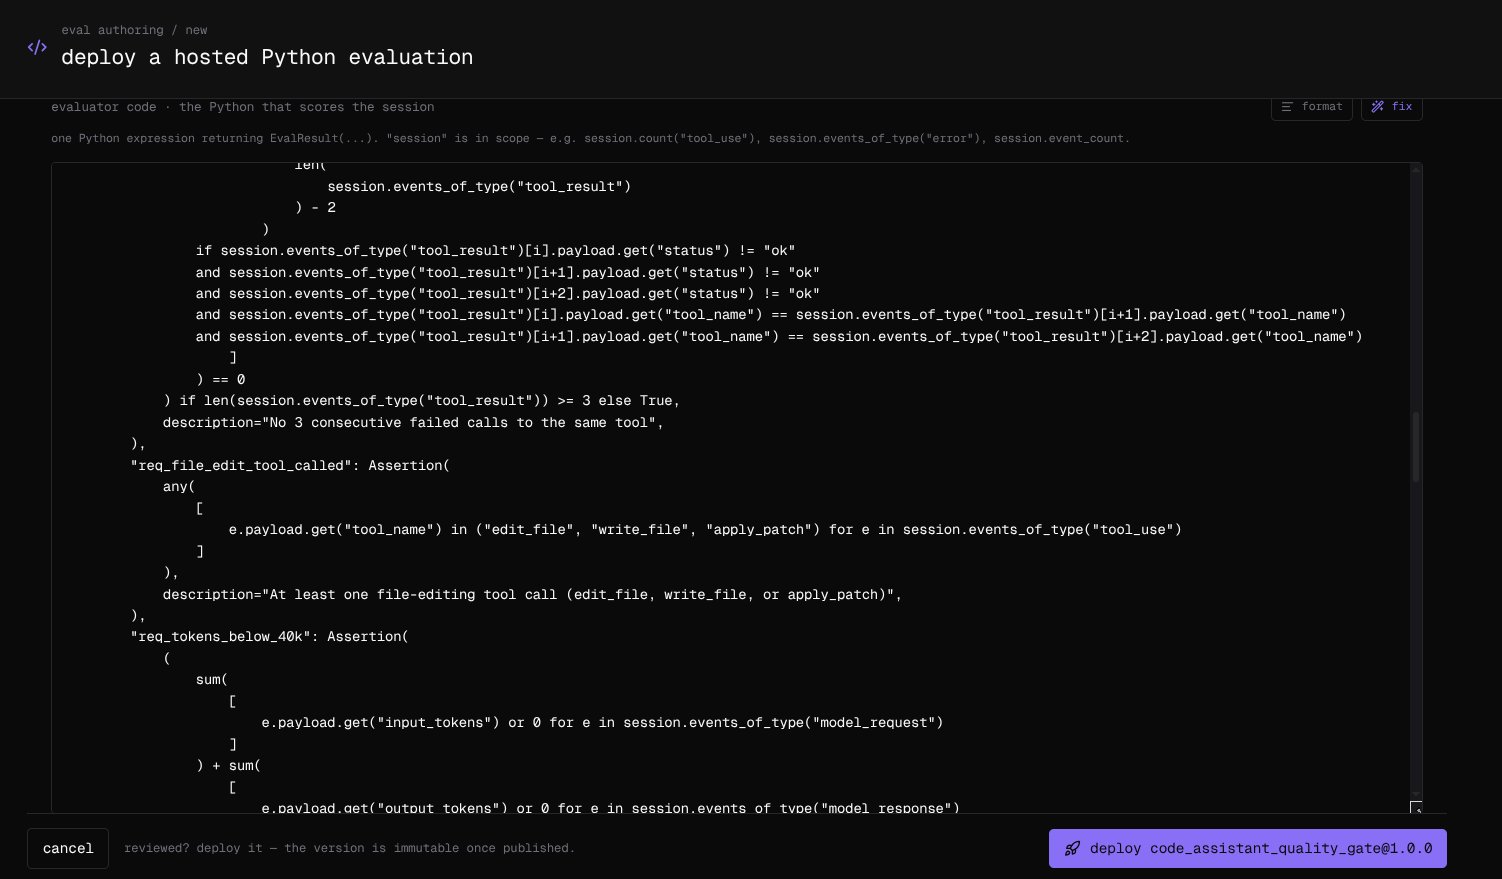
Результат начинается с собственного ключа оценки в объявленном типе: score= для оценки-балла или запись metrics или assertions с именем ключа для метрики или утверждения. Другие метрики и утверждения идут с ним, до 25 результатов в запуске. Больше ничего недоступно: нет импортов и нет атрибутов кроме данных сессии и простых методов строк и словарей, таких как get, lower и split, которые должны вызываться, а не просто ссылаться. Ключи полезной нагрузки — это всё, что отправляют ваши агенты — status выше только пример — поэтому берите их из реальной сессии. format приводит код в порядок, а fix просит помощника его исправить. Код может быть до 128 КиБ, условие — до 16 КиБ. Редактор кода оценки с форматированием и исправлением, показывающий утверждения составленной оценки.
Написать в своём воркере

Когда оценке требуется модель, пакет, секрет или сеть, напишите её с помощью Evaluator SDK и запустите в собственной инфраструктуре. Она использует те же типы результатов, и её результаты появляются рядом с размещёнными, помеченные customer: